
Видимости «в нейросетях» не существует: их столько же, сколько сервисов, и у каждого свой источник страниц.
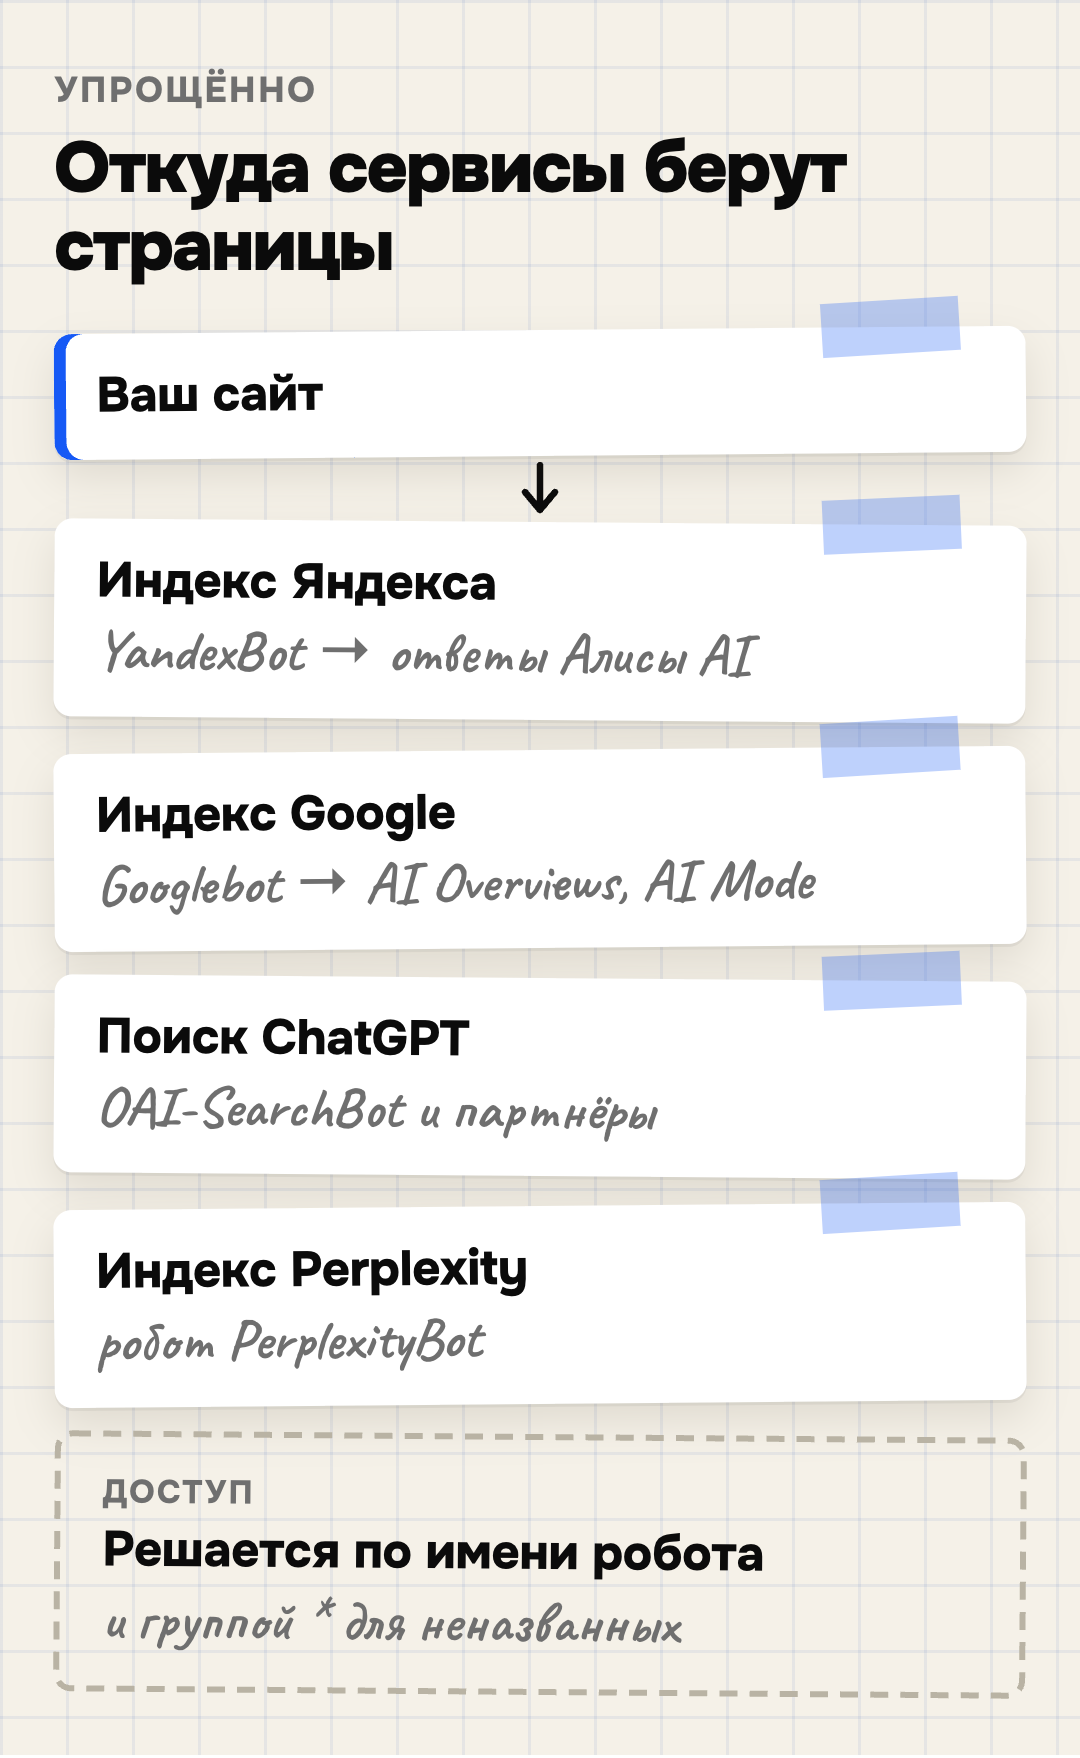
Поиск ChatGPT берёт страницы через своего робота и поисковых партнёров, Алиса AI — из поиска Яндекса, Perplexity — из своего индекса, Copilot — из Bing.
Поэтому расхождение — штатное состояние, а не поломка. Один и тот же сайт может быть источником в одном ответе и отсутствовать в другом, и причины у этого разные.
Ниже — из чего собирается ответ каждой системы и где обрывается путь от вашей страницы до цитаты.
Отдельно разберём, как отличить проблему доступа от проблемы индекса и выбора источника — и какую разницу вообще не надо лечить.
Статья объясняющая: механика сервисов и проверка своими руками. Чек-листа «как попасть» здесь нет — он разбросан по нашим материалам, ссылки стоят по ходу текста.
Коротко.
- Источник документов у каждого сервиса свой: Алиса AI — поиск Яндекса, AI Overviews — индекс Google, Copilot — Bing, ChatGPT — свой робот и партнёры.
- Упоминание компании и ссылка на её сайт — разные события: вас могут назвать по чужим обзорам или по тому, что модель усвоила при обучении.
- Доступ решается по именам роботов: запрет OAI-SearchBot убирает сайт из поиска ChatGPT, запрет GPTBot — только из обучения.
- Переходы это подтверждают: из 179 визитов из нейросетей на 14 сайтах 148 привёл ChatGPT (наш срез на 05.10.2026).
- Один вопрос ничего не доказывает: ответ собирается заново при каждом повторе. Даже серия вопросов — лишь гипотеза, её подтверждают логами и отчётами.
Почему ChatGPT знает вашу компанию, а Алиса отвечает, что не нашла
Сервисы берут сведения из разных источников и в разных режимах. Причины расхождения удобно разложить на три группы — по шагам отбора источников из следующего раздела.
Группа первая: до сайта не доходит нужный робот. У каждого сервиса свой краулер.
Например, Googlebot ходит, а OAI-SearchBot получает 403 от защиты сайта: в поиске Google вы есть, а в ответах ChatGPT ваш сайт не появляется.
Запрет не обязательно лежит в robots.txt. Межсетевой экран, CDN или антибот могут отдавать роботу ошибку, потому что имени краулера нет в белом списке.
Группа вторая: страницы нет среди документов сервиса.
Яндекс пишет, что ответы Алисы AI опираются на источники, высоко ранжирующиеся в поиске, а быстрые ответы с YandexGPT — на проиндексированные им страницы.
Позиции в Google здесь не помогают — это другой индекс. Так же у Microsoft: Copilot опирается на Bing.
Сайт, которого в Bing почти нет, вряд ли станет источником Copilot, как бы хорошо он ни стоял в Яндексе.
Группа третья: доступ и индекс в порядке, но источником выбрали другие страницы.
Компанию могут назвать по обзорам, каталогам, СМИ и форумам из индекса — и не сослаться при этом на её собственный сайт.
Отдельно от трёх групп стоит режим ответа. ChatGPT ищет в сети сам, когда вопрос этого требует, или по выбору пользователя.
Ответ с поиском показывает источники, ответ без поиска опирается на то, что модель усвоила при обучении.
Поэтому отсутствие ссылки на ваш сайт не говорит, откуда модель о вас знает.
Проверяйте с включённым веб-поиском и смотрите источники: если вас называют, а ссылки ведут на чужие обзоры, сведения взяты оттуда.
Отсюда практическое правило: записывайте отдельно, назвали ли компанию и сослались ли на ваш сайт. Лечится это по-разному, смешивать в одну «видимость» нельзя.
Пять шагов от страницы до ответа нейросети
Путь один и тот же у всех сервисов, различаются только участники. Выпасть можно на любом шаге, и на каждом — своя проверка и своё лечение.
- Доступ. Робот сервиса получает страницу. Не получил — дальше ничего не происходит; причину ищут в логах сервера и журналах защиты, а не в панелях.
- Индекс сервиса. Страница попадает в документы, из которых сервис берёт источники: у Алисы AI это поиск Яндекса, у AI Overviews — индекс Google.
- Совпадение с подвопросом. Система дробит вопрос человека на уточняющие и ищет по ним. Страница под общий запрос может не подойти ни под один.
- Извлекаемый фрагмент. В ответ берут не страницу, а кусок текста. Нет на странице прямого ответа — брать нечего, даже если она по теме.
- Выбор на фоне других. Из найденного отбирают ограниченное число фрагментов. Решают конкретность, свежесть и совпадение с другими источниками.
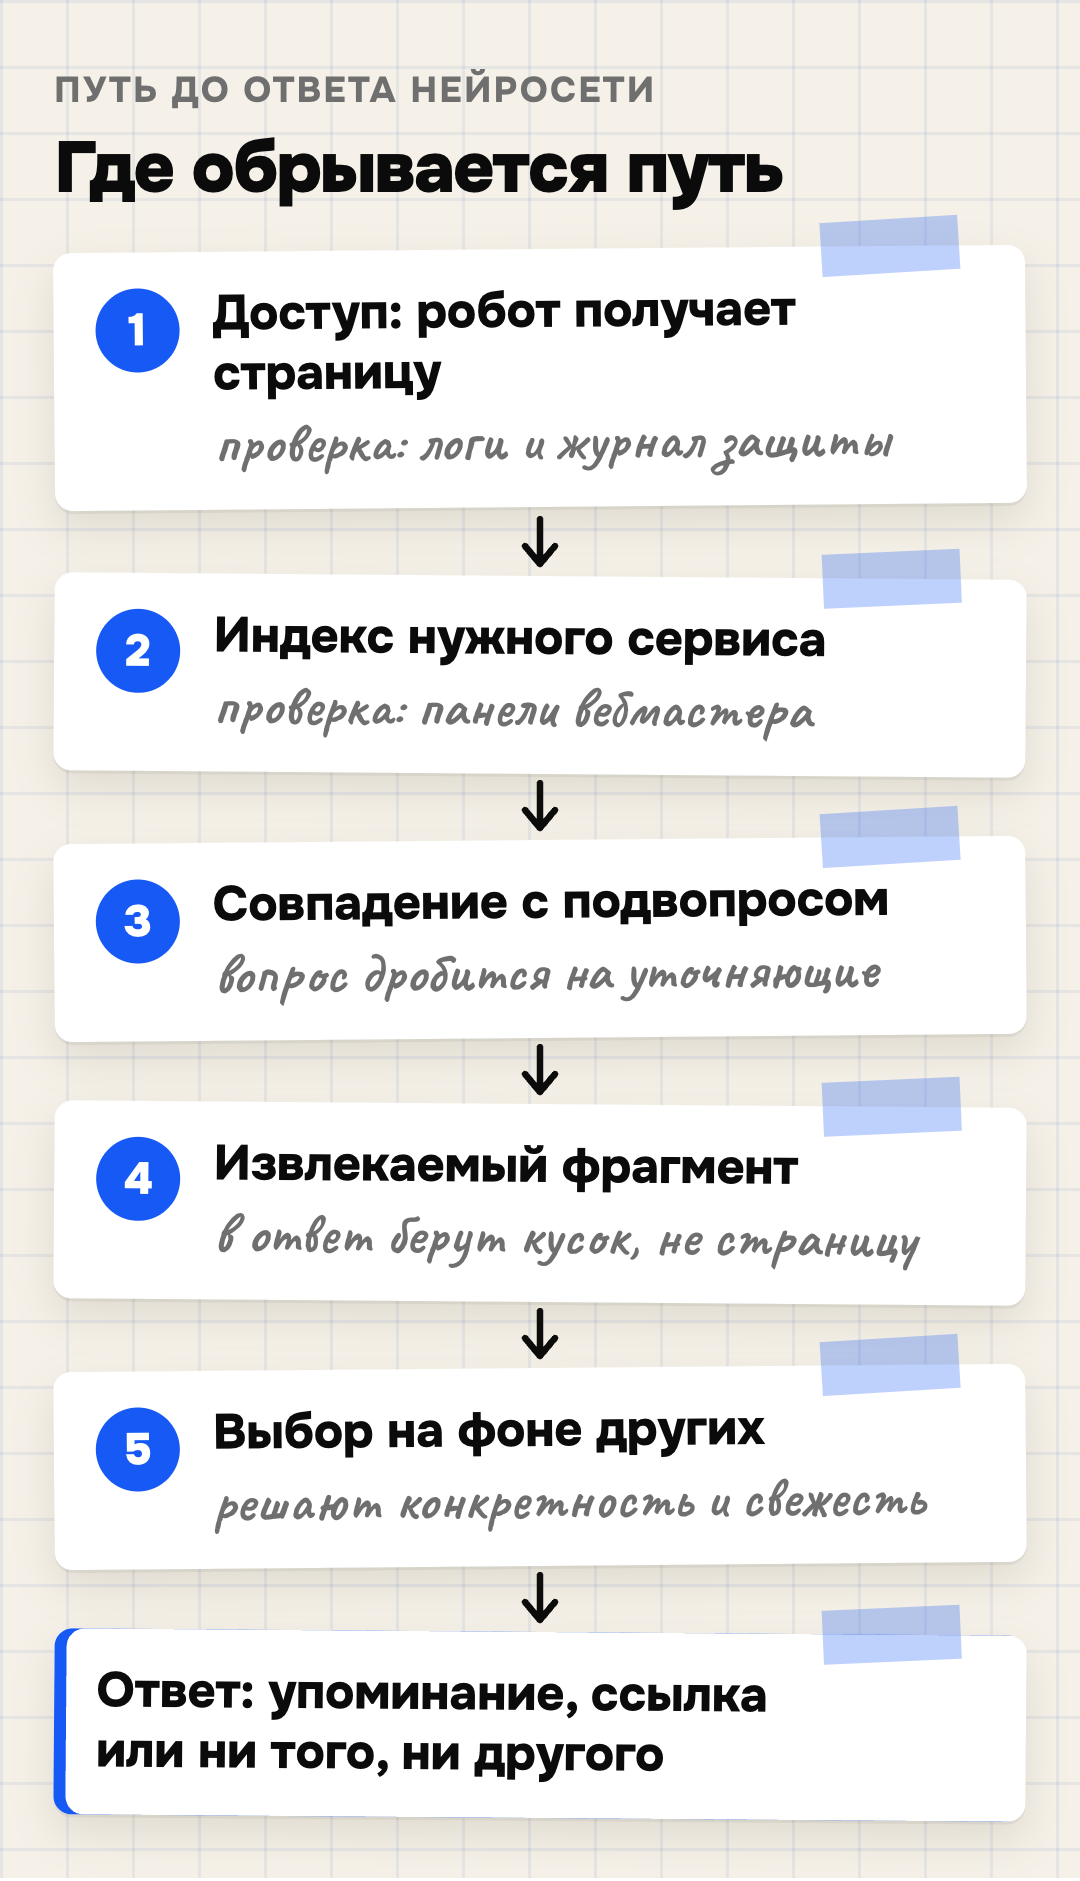
Первые два шага чинятся технически и проверяются по логам и панелям вебмастера.
Но открытый доступ не обязывает сервис обойти и показать страницу: Google прямо пишет, что обход, индексация и показ не гарантированы.
Последние три шага вероятностны ещё сильнее — там можно повышать шансы, но не обещать результат.
У каждой нейросети свой поиск и свой бот
Прямой ответ: сервисы различаются тем, откуда берут документы и каким ботом их забирают.
Таблица ниже собрана по справкам вендоров; по DeepSeek документации мы не нашли, там только сторонний реестр.
| Сервис | Откуда берёт источники | Чем закрывается доступ |
|---|---|---|
| Поиск ChatGPT | Собственный обход OAI-SearchBot и сторонние поисковые партнёры, которым уходят переписанные запросы | Запрет OAI-SearchBot; GPTBot отвечает только за обучение |
| Алиса AI в Поиске Яндекса (прежде — Нейро) | Страницы, которые высоко ранжируются в поиске Яндекса | Отдельная группа для YandexAdditional или YandexAdditionalBot |
| AI Overviews и AI Mode | Индекс Google; страница должна быть годна к показу со сниппетом | robots.txt для Googlebot закрывает обход и для обычного поиска, но адрес может остаться в выдаче; noindex убирает страницу, если робот может её прочитать; nosnippet и max-snippet ограничивают текст |
| Perplexity | Собственный поисковый индекс | Запрет PerplexityBot и правила межсетевого экрана |
| Microsoft Copilot | Индекс Bing и отдельные партнёрские интеграции | Запрет Bingbot — то же, что выпасть из Bing |
| DeepSeek | Документации вендора о поиске не нашли; в реестре ai.robots.txt — только обучающий бот | Документированного способа мы не нашли |
Два вывода из таблицы. Первый: «открыть доступ нейросетям» одной строкой нельзя — решение принимается по каждому имени, и смысл у имён разный.
Второй: у OpenAI и Perplexity поиск отделён от обучения. Запрет GPTBot не выбрасывает вас из ответов поиска ChatGPT.
А PerplexityBot, по справке сервиса, для обучения моделей не используется вовсе.
По DeepSeek у нас только сторонний источник: в открытом реестре AI-ботов ai.robots.txt за ним числится DeepSeekBot.
Назначение у него — «обучение моделей», с пометкой, что robots.txt он не соблюдает.
Документации DeepSeek о поиске, отчётах для вебмастеров или порядке отказа мы не нашли. Поэтому проверенного способа управлять видимостью в DeepSeek не называем.
И не ищите в логах DeepSeekBot как доказательство: визиты обучающего бота о видимости в ответах ничего не говорят.
Почему один и тот же вопрос даёт разные источники
Часть расхождения вообще не про ваш сайт. Системы не ищут по вашей фразе — они переписывают вопрос по-своему, и у каждой получается свой набор подзапросов.
Google называет это query fan-out: по одному вопросу запускается серия связанных поисков по подтемам.
Там же сказано, что AI Overviews и AI Mode могут работать на разных моделях, поэтому наборы ссылок у них различаются.
Яндекс описывает похожий механизм: Алиса AI задаёт уточняющие подвопросы, обращается с ними к Поиску и собирает ответ по смысловым блокам.
OpenAI пишет о том же для поиска ChatGPT: вопрос переписывается в узкие запросы для поисковых партнёров, а после первых результатов могут уйти уточняющие.
Деталь, которую легко упустить: ссылки в ответе Алисы не ранжируются, а стоят по смыслу ответа.
Их бывает больше, чем в обычной выдаче, а ссылка на одну страницу может повториться.
Отсюда главный запрет на выводы. Спросили ChatGPT один раз и себя не увидели — вы не узнали ничего: при повторе состав источников меняется.
Рабочая проверка — серия: мы берём 30 вопросов покупателя и прогоняем их через три-четыре сервиса.
Как выглядит такой прогон и кого называют вместо вас — в статье про продвижение в нейросетях.
Сколько переходов дают нейросети: наши данные
Асимметрию видно и в трафике. За 90 дней на 14 сайтах наших клиентов нейросети дали 179 визитов против 134 481 из поиска — 0,13% (срез на 05.10.2026).
Разбивка по сервисам и есть та самая разница: ChatGPT привёл 148 визитов, Perplexity — 17, Gemini — 10, остальные вместе — 4. Сайты и период одни и те же.
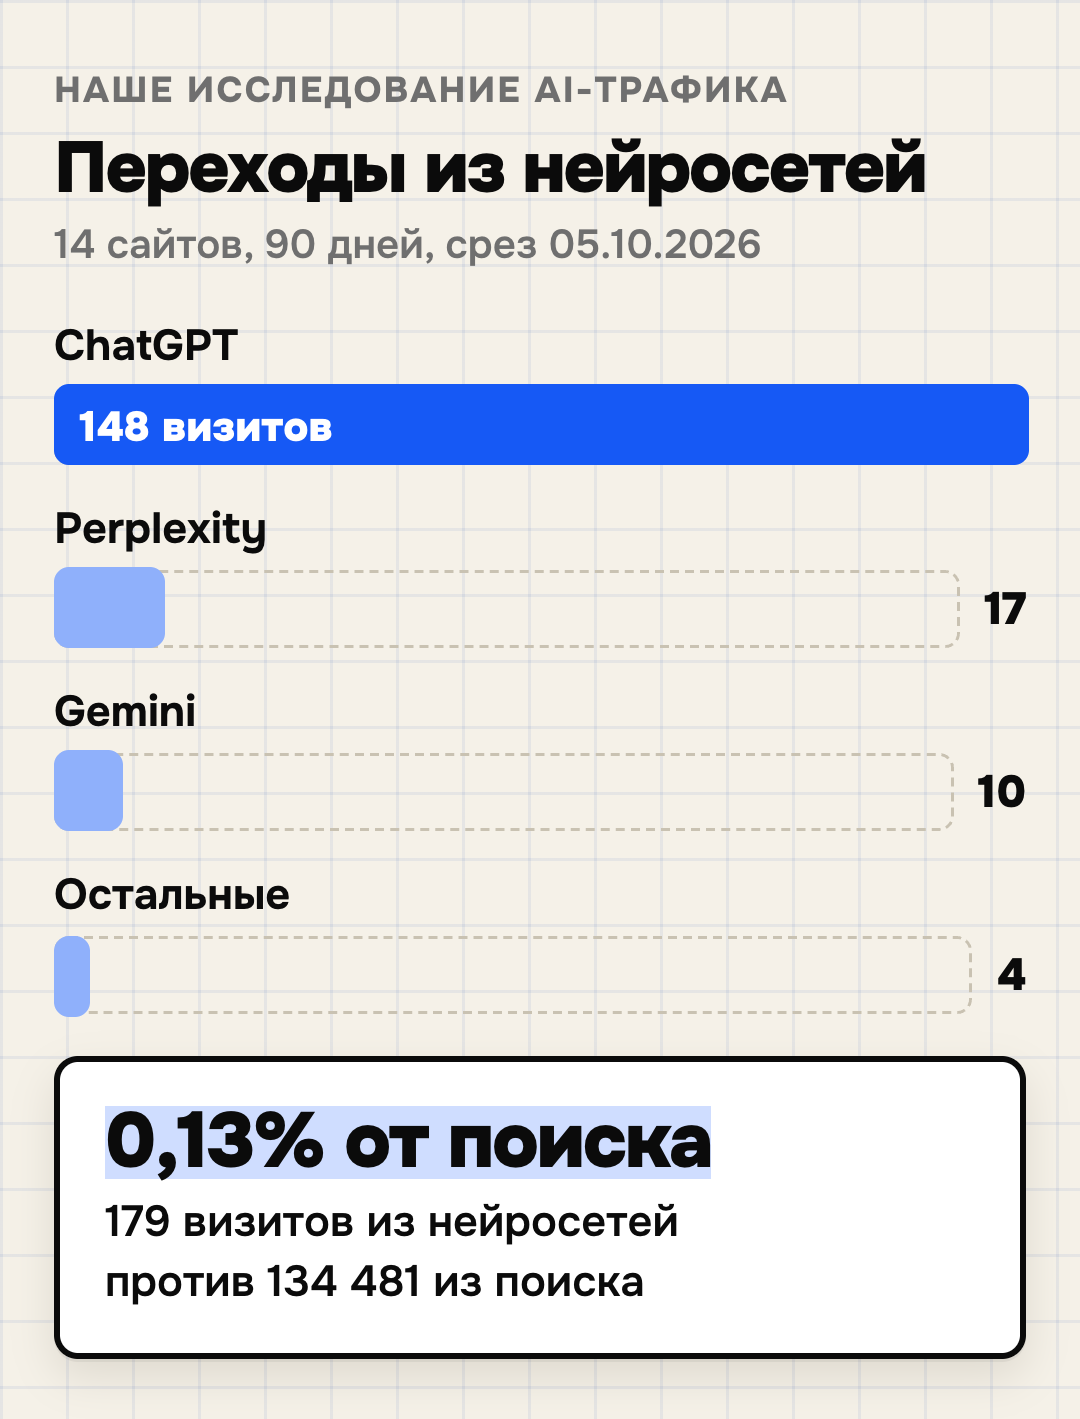
Полные цифры по месяцам, доля от органики и методика — в исследовании трафика из ChatGPT и Perplexity. Оно обновляется еженедельно, числа в нём меняются.
Важнее то, чего разбивка не измеряет. Переходы из ответов Алисы AI в Поиске Метрика относит к поисковым.
А часть переходов из приложения ChatGPT приходит без метки источника.
Значит, по трафику нельзя сказать «в Яндексе нас не цитируют»: российская часть в этой цифре просто не отделена. Это нижняя оценка канала, а не замер видимости.
Ещё одно наблюдение из нашего прогона на 90 ответов: магазин не был назван ни разу, а ссылку на его страницу нейросеть дала один раз.
Упоминание бренда и ссылка — два разных события, считать их вместе нельзя.
Когда дело в доступе: запрет по имени закрывает одну нейросеть
Самая дешёвая причина невидимости — техническая, и проверяется она первой. Выглядит она не как ошибка на сайте, а как тишина: сервис просто не получает страницу.
Главное, что путает: правила по именам независимы. OpenAI так и пишет — настройки OAI-SearchBot и GPTBot не связаны, сайт может разрешить поиск и запретить обучение.
Но «независимы» не значит «без имени — без правил».
Группа User-agent: * с Disallow: / без других групп закрывает и OAI-SearchBot, и PerplexityBot, хотя их имён в файле нет.
У роботов Яндекса свой порядок групп: группа с именем робота важнее группы Yandex, а та важнее *. Если нет ни Yandex, ни *, доступ не ограничен.
Исключение — YandexAdditional: по справке Яндекса общие правила robots.txt он не учитывает.
Поэтому запрет для ответов Алисы AI пишут отдельной группой с его именем; общий запрет его не касается.
Вторая особенность YandexAdditional: он сам страницы не скачивает. Его имя управляет показом уже проиндексированных страниц.
Поэтому в логах сервера вы его не найдёте — там ищут YandexBot.
Следующая причина живёт на сервере. Perplexity прямо просит вносить своих ботов в белый список межсетевого экрана по опубликованным диапазонам адресов.
И последнее: фетчеры по просьбе человека могут игнорировать robots.txt. ChatGPT-User ходит на страницу по запросу пользователя и на показ в поиске не влияет.
Какие имена за что отвечают, какие закрывать и как сверить доступ по логам — в статье про AI-ботов в robots.txt.
Там же наш срез: из 79 прочитанных файлов российских сайтов имя AI-бота встретилось в 13.
Сроки, из-за которых кажется, что ничего не работает: OpenAI учитывает правку robots.txt для поиска примерно за сутки, Perplexity — до суток, Яндекс — за 2–14 дней.
Как понять, на каком шаге вы выпали
Каждое наблюдение ниже даёт гипотезу и следующую проверку, а не готовый диагноз. Порядок важнее инструментов: сначала доступ, потом индекс, потом отбор.
- В логах за месяц нет обращений поискового бота сервиса. Это ещё не причина: робот мог не прийти, а логи — не видеть запросов, отбитых CDN или защитой.
- Следующая проверка: убедитесь, что логи полные, найдите действующую группу robots.txt для робота и посмотрите в журнале защиты, что он получает.
- В логах есть отказ — 403 или 429 настоящему роботу на нужный адрес. Это уже причина. Подлинность робота сверяют по диапазонам адресов OpenAI и Perplexity.
- Бот получает страницу, но её нет в индексе нужного поисковика — вероятно, дело в индексе. Проверьте по отдельности Вебмастер, Search Console и Bing Webmaster Tools.
- Страница доступна и в индексе, но в ответах её нет — вероятно, её не выбрали источником. Посмотрите, чьи страницы стоят вместо вашей и чем их ответ прямее.
Где смотреть каждую часть — в таблице. Отдельно указано, чего в отчёте нет: это главная причина неверных выводов.
| Где смотреть | Что показывает | Чего там нет |
|---|---|---|
| Вебмастер, «Видимость сайта в Алисе AI» | Долю упоминаний и примеры запросов, по которым сайт виден | Кликов и показов; данных по запросам, где сайт не стоит высоко |
| Search Console, отчёт «Эффективность» | Клики и показы, включая AI-функции, в типе поиска «Веб» | Отдельной строки AI Overviews или AI Mode |
| Bing Webmaster Tools, AI Performance | Цитирования в Copilot и AI-ответах Bing, URL и grounding-запросы | Данных по ChatGPT, Алисе и Perplexity |
| Логи сервера и журнал защиты | Приход конкретного робота и код ответа ему | Запросов, отбитых до сервера, если их не пишет CDN; связи визита с ответом |
| Серия вопросов руками | Кого называют вместо вас и какие источники берут | Стабильности: ответ меняется при повторе |
В Bing Webmaster Tools отчёт AI Performance показывает цитирования в Copilot, AI-ответах Bing и поддерживаемых партнёрских интеграциях.
Порядок не переставляйте. Переписывать страницы, когда бота блокирует межсетевой экран, — самый дорогой способ ничего не изменить.
Что лечится сразу во всех нейросетях, а что только в одной
Общий слой есть, и он совпадает с обычным SEO. Google пишет прямо: отдельных требований для AI Overviews и AI Mode нет, нужны индексация и годность к показу со сниппетом.
Дополнительные файлы и особая разметка в той же справке названы ненужными. Почему llms.txt продвижением не является, разобрано в отдельной статье.
Поэтому отдельной дисциплины «GEO вместо SEO» не возникает: меняется не база, а требования к странице. Что проверяют специалисты — в гайде по GEO и AEO.
Во всех сервисах сразу работают прямой ответ в начале смыслового блока, конкретные цифры и условия вместо оценок, согласованные данные о компании на сайте и вне его.
Только в своём сервисе работают индексация в нужном поисковике, доступ конкретному боту и сервисы экосистемы — например, карточка организации для ответов Яндекса.
Товарная часть стоит особняком: в рекомендации нейросетей товары попадают через фид и разметку карточки, и у каждой системы требования свои.
Это разобрано в статье про товары в рекомендациях нейросетей.
Если тема для вас новая, начинать стоит не с нейросетей, а с порядка в индексации и структуре. План по неделям — в статье про подготовку сайта к AI-поиску.
Какое расхождение считать нормой
Разница между сервисами — норма, одинаковой видимости не бывает ни у кого. Лечить нужно не разницу, а полное отсутствие там, откуда к вам приходят люди.
Три ориентира, по которым мы сами решаем, стоит ли вмешиваться:
- Вас нет ни в одной системе по всей серии — проверьте общий слой: доступ, индекс, содержание. Причину серия не доказывает: вопросы могли разойтись с вашими страницами.
- Вас называют в части систем и не называют в остальных — рабочая ситуация. Смотрят, какой сервис приводит покупателей, и занимаются им.
- Вас перестали называть там, где называли раньше, — повод для проверки по порядку из раздела выше, начиная с логов и индекса.
Ещё один ориентир — масштаб канала. Пока на сайтах, которые мы ведём, нейросети дают 0,13% поискового трафика, решать по ним стоит после обычного поиска, а не вместо него.
Гарантий в этой области нет ни у кого. Ответ зависит от формулировки, модели, региона и времени — повысить шансы можно, пообещать место в ответе нельзя.
Справки, на которые мы опирались
Механика сервисов описана по документации вендоров, а не по пересказам. Ссылки на ключевые справки стоят в тексте рядом с утверждениями.
- Google Search Central: «AI-функции и ваш сайт» и «Метатеги robots».
- Яндекс Вебмастер: ответы Алисы AI, быстрый ответ, директива User-agent, список роботов; новости Яндекса от 22.05.2025 и 07.04.2026.
- OpenAI: обзор краулеров и справка о поиске ChatGPT.
- Perplexity: справка о краулерах. Bing Webmaster Tools: анонс отчёта AI Performance.
- DeepSeek: документации не нашли, только сторонний реестр ai.robots.txt.
FAQ: видимость в разных нейросетях
Можно ли закрыть одну нейросеть и не потерять остальные?
Да, если у сервиса свой робот: запрет GPTBot оставляет вас в поиске ChatGPT, а группа YandexAdditional убирает страницы из Алисы AI, но не из поиска Яндекса.
У Google такого робота нет. Запрет Googlebot закрывает обход и обычному поиску, хотя адрес может остаться; noindex работает на прочитанной странице; текст урезают nosnippet и max-snippet.
Можно ли быть видимым в нейросети, не имея страницы в её индексе?
Назвать компанию — да. Поисковый ответ может опереться на чужие обзоры и каталоги о вас, а ответ без веб-поиска — на то, что модель усвоила при обучении.
Ссылкой на ваш собственный сайт ответ стать не может, пока страница недоступна источникам, к которым обращается этот сервис.
Алиса AI, Яндекс Нейро и обычная выдача Яндекса — это одно место или разные?
Нейро — прежнее название: в мае 2025 года Яндекс объявил, что его возможности унаследует Алиса в Поиске. Проверяют ответ Алисы AI, вкладку «Алиса AI» и обычную выдачу.
Приложение Алисы справка Вебмастера не описывает, его источники мы не обсуждаем. «Нас нет в Алисе» уточняйте: нет в ответе над выдачей, в диалоге или просел поиск.
Если сайт виден в Perplexity, значит ли это, что он виден в ChatGPT?
Нет. У Perplexity свой индекс и свой бот, у поиска ChatGPT — свой бот и поисковые партнёры.
Видимость в одном сервисе говорит о другом лишь то, что контент в принципе пригоден для цитирования.
Сколько нейросетей надо проверить, чтобы понять, что дело в сайте?
Число сервисов само по себе этого не доказывает. Для первичного замера мы берём три сервиса и серию вопросов с веб-поиском, бренд и ссылки записываем отдельно.
Если вас не называют нигде, это гипотеза об общей причине. Подтверждают её логами, отчётами об индексе и разбором источников, показанных вместо вас.
Почему один и тот же вопрос один раз даёт мой сайт, а при повторе — нет?
Ответ собирается заново при каждом обращении, а вопрос дробится на подзапросы.
Стабильной позиции в нейросетях нет, поэтому считают долю упоминаний по серии вопросов, а не факт одного ответа.
Что делать, пока открытый доступ ещё не дал результата?
Само правило применяется быстро — от суток до двух недель в зависимости от сервиса. Дольше идёт переобход страниц и пересборка источников, и повлиять на этот срок нельзя.
В это время смотрят логи: пришёл ли нужный робот и с каким кодом. Ответы проверяют позже и серией, иначе не отличить «ещё не обошли» от «не выбрали».
Что проверить сегодня
Шаги ниже — четыре проверки: robots.txt, логи, панели вебмастера и серия вопросов. robots.txt смотрится за минуту, остальное займёт вечер.
Шаги 1 и 2 быстрее сделать нашим бесплатным расширением для Chrome PrivateSEO AI Auditor: откройте страницу, и вкладка GEO покажет, пускает ли её robots.txt к OAI-SearchBot, PerplexityBot, YandexBot и другим роботам.
Если не пускает — покажет и строку, которая закрывает. YandexAdditional расширение не проверяет: его группу смотрите в файле сами.
Выводы делайте только после всех четырёх проверок, и это гипотезы, которые уточняются следующим шагом.
- Откройте robots.txt и найдите группу, которая действует для OAI-SearchBot, PerplexityBot и YandexBot: свою по имени или общую
*. - Посмотрите в этой группе Disallow и Allow. YandexAdditional общие правила не учитывает — его группу проверяют отдельно.
- Попросите администратора выгрузить из логов сервера и журнала защиты обращения этих роботов за месяц с кодами ответа.
- 403 или 429 на нужные адреса — причина найдена. Ноль обращений — сначала проверьте, полные ли логи.
- Проверьте одну важную страницу в трёх панелях: Вебмастер, Search Console, Bing Webmaster Tools. Сайт не подтверждён — начните с подтверждения.
- Задайте пять вопросов покупателя в ChatGPT с веб-поиском, Алисе и Perplexity, по два раза каждый.
- Запишите отдельно: назвали ли компанию, сослались ли на ваш сайт и чьи страницы стоят в источниках.
Если по всей серии вас не называют нигде, а доступ и индекс в порядке, разовыми правками это обычно не закрывается.
Нужен замер по банку вопросов, разбор источников конкурентов и работа с внешними упоминаниями.
Как это устроено у нас — в услуге GEO-продвижения в нейросетях.
Там же сроки: исходный замер — первые две недели, первые упоминания по части вопросов — через 2–3 месяца.


