
Проверить сайт в Screaming Frog самому можно бесплатно: скачайте программу с официального сайта, введите адрес и нажмите Start. Бесплатная версия обходит до 500 адресов за раз, регистрация не нужна.
Дальше смотрите пять мест: коды ответа, индексируемость, заголовки, canonical с дублями и картинки. А попала ли страница в поиск, программа не знает — это сверяют в Яндекс Вебмастере и Search Console.
Коротко.
- Бесплатная версия обходит до 500 адресов за раз. Лицензия стоит £199 в год на одного человека и снимает лимит.
- Без лицензии настройки обхода закрыты и обход нельзя сохранить, поэтому нужные таблицы выгружайте до того, как закроете программу.
- Для первой проверки хватит пяти мест: Response Codes, колонка Indexability, Page Titles и H1, Canonicals с дублями, Images.
- Indexable значит «можно индексировать», а не «в индексе». В robots.txt программа берёт правила для Googlebot или общие, а секцию для Яндекса не читает — её проверяют в Вебмастере.
- Приоритет во вкладке Issues — подсказка, а не план работ. После правок нужен новый обход: старые 404 сами из отчёта не уйдут.
Что такое Screaming Frog SEO Spider и кому хватит бесплатной версии
Screaming Frog SEO Spider — программа для компьютера, которая обходит страницы сайта по ссылкам, как поисковый робот. По каждому адресу она собирает код ответа сервера, title, H1, canonical и запреты индексации.
Код ответа — число, которым сервер отвечает на запрос: 200 — страница открылась, 301 — переадресация на другой адрес, 404 — страницы нет. Canonical — указание, какой адрес считать основным.
Страницы программа находит так: открывает стартовый адрес, читает в коде ссылки и идёт по ним дальше. Работает на 64-битных Windows, macOS и Linux, Java ставить отдельно не нужно — она уже внутри.
По-русски её часто пишут «Скриминг Фрог», ищут и как «SEO Frog Screaming Spider», а сам обход называют сканированием сайта или парсингом: запрос «Screaming Frog парсинг сайта» — о том же.
Почта и регистрация не нужны: бесплатной версией SEO Spider пользоваться можно сразу после установки, если на сайте до 500 адресов.
Обзор всех вкладок владельцу сайта не нужен. Ниже — маршрут для первой проверки и границы бесплатной версии.
Screaming Frog: бесплатная версия и лицензия
Бесплатно доступны все базовые проверки: битые ссылки, редиректы, title и описания, запреты индексации, точные дубли. Лицензия снимает лимит в 500 адресов, открывает настройки и платные функции.
| Задача | Бесплатно | С лицензией |
|---|---|---|
| Обход сайта | До 500 адресов за обход | Без лимита 500, предел задают память и диск |
| Битые ссылки, редиректы, title и description, запреты индексации в коде страниц, точные дубли | Есть | Есть |
| Похожие, но не одинаковые страницы | Нет | Есть |
| Настройки обхода: скорость, robots.txt | Нет, работают значения по умолчанию | Есть |
| Сохранить обход, сравнить два обхода | Нет | Есть |
| Выполнение JavaScript | Нет | Есть |
| Search Console, Google Analytics, PageSpeed Insights | Нет | Есть |
| Поиск по коду, микроразметка, орфография | Нет | Есть |
| Техническая поддержка | Нет | Есть |
Полный список — на странице сравнения бесплатной и платной версии. У Screaming Frog лицензия стоит £199 в год и выдаётся на одного человека: двоим сотрудникам нужны две. Скидки есть только от пяти лицензий.
Ставить программу можно на несколько своих устройств, но работать в ней должен владелец лицензии. Когда год кончается, программа снова становится бесплатной: лимит 500, настройки закрыты, сохранённые обходы не открываются.
Цена указана в фунтах, платят картой или через PayPal. Создатели программы предупреждают: банки часто сами блокируют международные покупки. Тогда предлагают другую карту, PayPal или банковский перевод через поддержку.
Ключ лицензии: где взять и почему не keygen
У Screaming Frog ключ выдают только при покупке: его показывают после оплаты, присылают письмом «Screaming Frog SEO Spider licence details» и хранят в личном кабинете, в разделе licence keys.
- В SEO Spider ключ вводят через меню Licence → Enter Licence Key.
- Скопируйте из письма имя пользователя и ключ и вставьте их в поля. Набирать вручную не стоит: имя пользователя лицензии — не адрес почты, на этом чаще всего и ошибаются.
- Перезапустите программу — после этого лимит снимется и откроются настройки.
По запросам «Screaming Frog key» и «Screaming Frog keygen» в выдаче стоят сторонние сайты с «ключами». Их выдаёт не производитель, а скидочные коды с чужих сайтов создатели программы прямо называют ненастоящими.
Ставить на рабочий компьютер сборку с чужим ключом мы не советуем — это рекомендация редакции. Для проверки небольшого сайта честной бесплатной версии хватает.
Как скачать Screaming Frog SEO Spider и запустить первый обход
С сайта Screaming Frog скачать программу можно бесплатно: screamingfrog.co.uk, раздел SEO Spider. Других источников не нужно, а главное при первом запуске — ввести правильную версию адреса.
- На странице SEO Spider скачать можно версии для Windows, macOS и Linux: выберите свою систему и установите программу как обычно.
- Откройте сайт в браузере и скопируйте адрес главной из строки — с https и тем вариантом www, на который сайт открывается.
- Вставьте адрес в поле Enter URL to spider вверху окна и нажмите Start.
- Дождитесь конца обхода. Таблицы заполняются по ходу, но выводы лучше делать по полному обходу.
- До того как закрыть программу, выгрузите нужные таблицы: сохранить обход в бесплатной версии нельзя.
Версия адреса важна, потому что программа обходит тот поддомен, который вы ввели, а остальные считает внешними сайтами. Если ввести корень без www, по умолчанию она пройдёт и по поддоменам, на которые есть ссылки.
Обход идёт в 5 потоков — так задано, чтобы не перегружать сервер. Скорость и время обхода создатели программы советуют заранее согласовать с тем, кто отвечает за сервер.
Если сайт больше 500 адресов
Если обход остановился на 500 адресах, возможно, достигнут бесплатный лимит. Проверьте, все ли нужные страницы попали в обход: поищите на вкладке Internal адреса нескольких важных страниц из глубины сайта.
На этой вкладке кроме страниц лежат картинки, стили и скрипты — у каждого файла свой адрес. Сколько в обходе именно страниц, покажет фильтр HTML.
Справка предлагает обходить сайт по разделам: ввести адрес раздела со слешем на конце, например https://site.ru/catalog/, и выбрать Subfolder в переключателе вверху окна.
У раздела должна открываться страница со ссылками на остальные.
Переключатель стоит в главном окне, а не в меню настроек, и в списке платных функций его нет. Если раздел всё равно больше 500 адресов, целиком его обойдёт только версия с лицензией.
Как настроить Screaming Frog: что доступно без лицензии
В бесплатной версии меню настроек обхода закрыто, и программа работает со значениями по умолчанию. Советы из чужих инструкций «зайдите в Configuration» относятся к платной версии.
В Screaming Frog настройки обхода собраны в меню Configuration: там с лицензией меняют скорость, правила robots.txt, имя, которым программа представляется сайту (user-agent), обход карты сайта. Без лицензии действует вот что:
- robots.txt соблюдается. Это файл в корне сайта, где написано, какие разделы роботам не обходить: закрытые в нём адреса программа не откроет, а игнорировать файл можно только в платной версии;
- ссылки с атрибутом nofollow (просьба роботу не переходить по ссылке) не проходятся;
- JavaScript не выполняется: ссылки, которые появляются только после работы скриптов, программа не видит;
- XML-карта сайта не обходится — страницы ищутся только по ссылкам;
- другие поддомены считаются внешними сайтами, если вы ввели адрес с www или с другим поддоменом.
Что делать, если сайт не даёт себя обойти
Сначала посмотрите первую строку во вкладке Internal. У стартового адреса должен быть код 200 и статус OK. Код 0 со статусом Blocked by Robots.txt значит, что сайт закрыт для обхода в robots.txt.
В этом случае откройте в браузере адрес вашего сайта с /robots.txt на конце. Строка Disallow: / закрывает весь сайт — попросите разработчика проверить файл: в бесплатной версии запрет не обойти.
Ответы 403 Forbidden и 429 Too Many Requests означают, что сайт или его защита блокирует саму программу. С лицензией снижают скорость обхода, в бесплатной версии этой настройки нет.
- Если 403 появляется на отдельных адресах время от времени, нажмите правой кнопкой по адресу и выберите Re-Spider — справка советует это для бесплатной версии.
- Если блокировка постоянная, попросите добавить ваш IP-адрес и user-agent «Screaming Frog SEO Spider» в разрешённые в настройках сервера или защиты сайта. Как это сделать, подскажет хостинг или сервис защиты сайта.
Как проверить сайт в Screaming Frog: пять мест по порядку
Начните с того, что ломает доступ к страницам, и закончите картинками. Такой порядок — рекомендация редакции: первыми найдутся проблемы, из-за которых страница выпадает из поиска или посетитель упирается в ошибку.
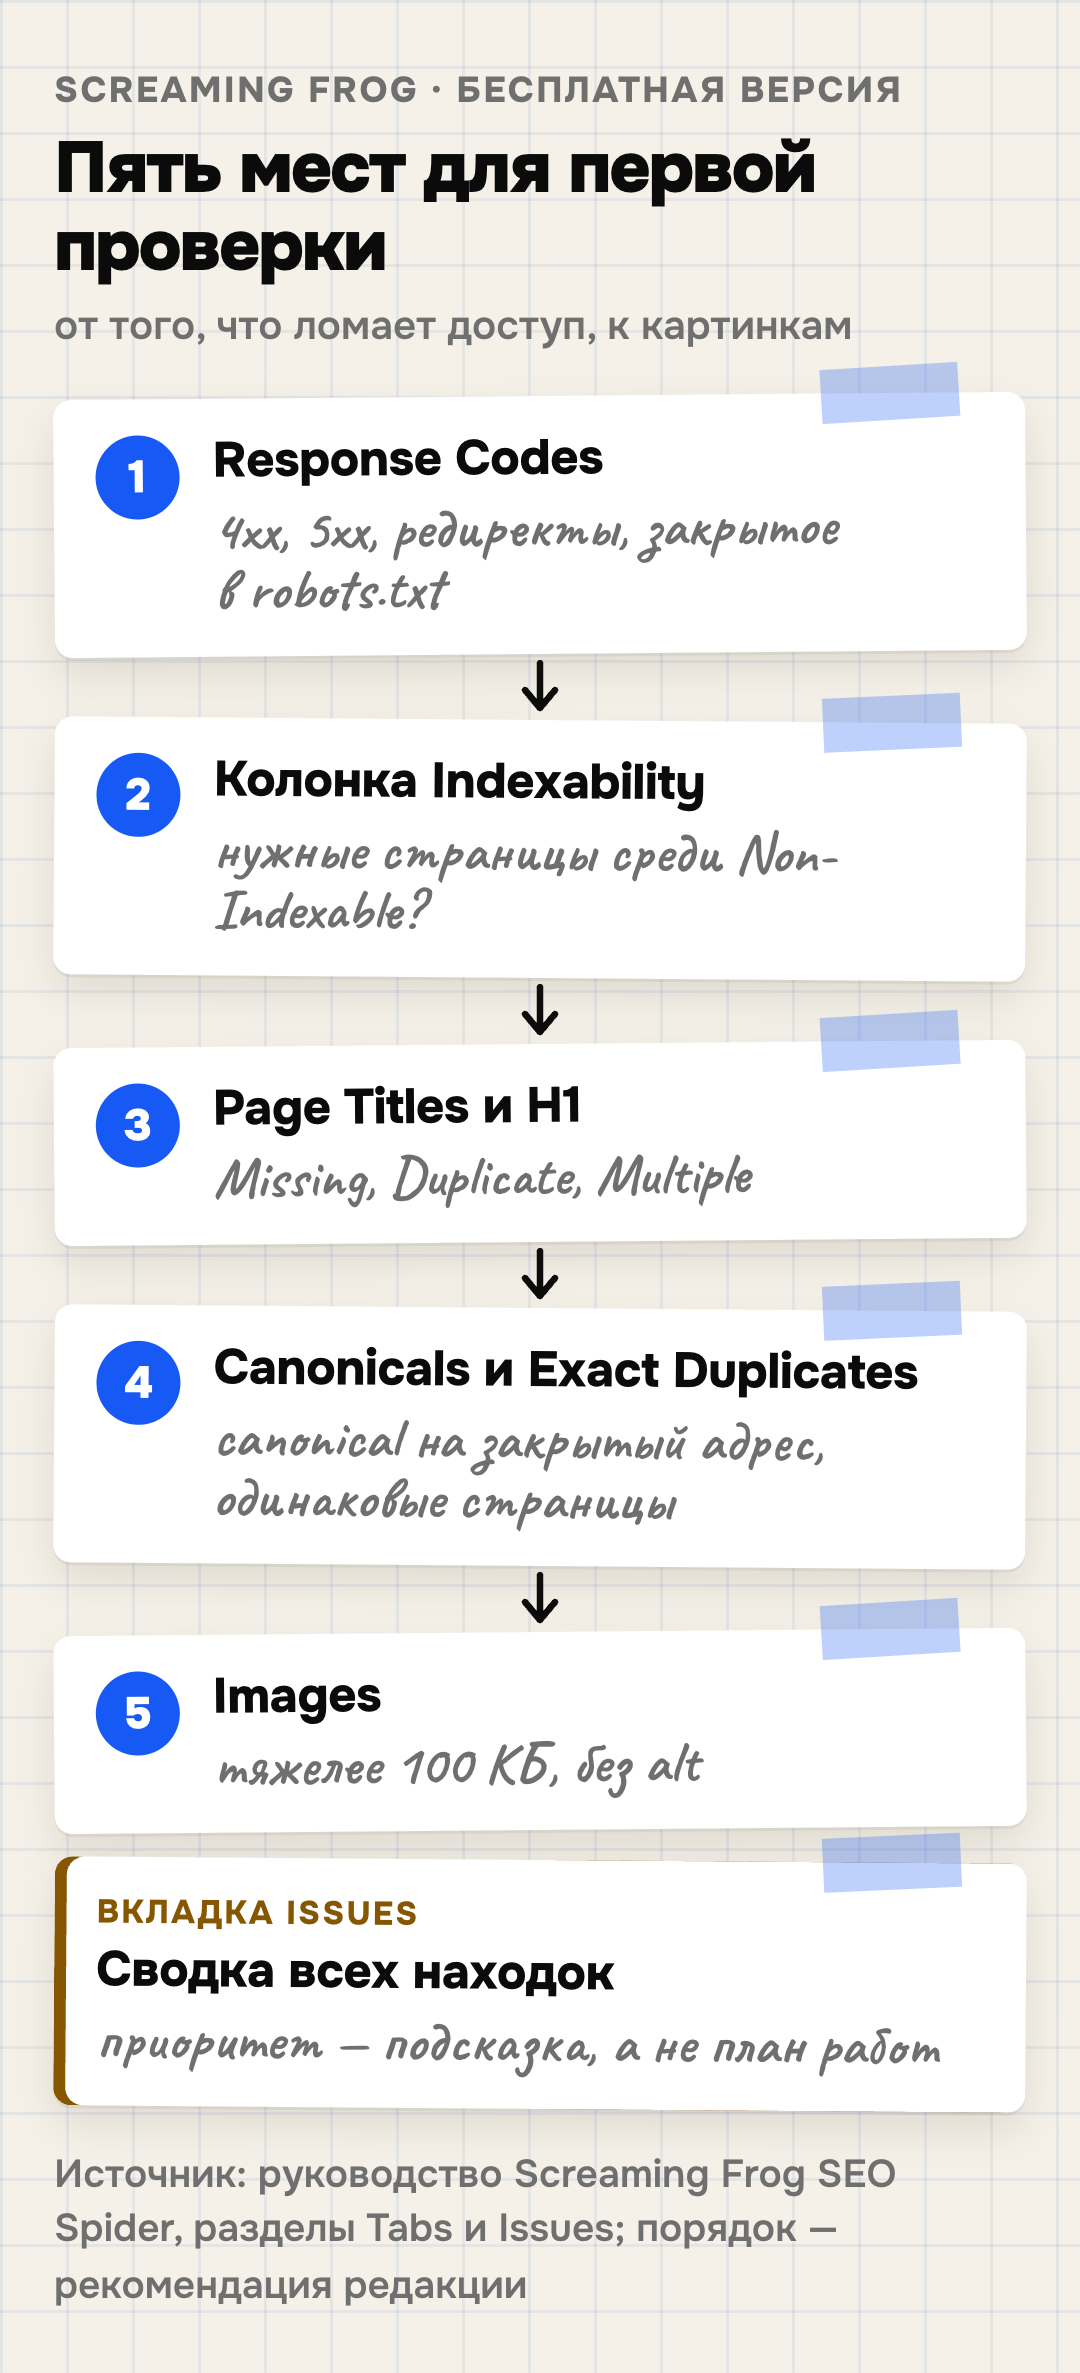
Response Codes: битые ссылки, редиректы, ошибки сервера
Response Codes показывает, какие адреса отвечают ошибкой. Здесь видны и внутренние, и внешние адреса, главные фильтры такие:
- Client Error (4xx) — страницы, которых нет (404, 410), а также 403 и 429: так сайт отказывает самой программе;
- Server Error (5xx) — сервер не смог отдать страницу;
- Redirection (3xx) — ссылка ведёт на редирект, а Redirect Chain — на цепочку редиректов;
- Blocked by Robots.txt — адреса, закрытые в robots.txt. В колонке Matched Robots.txt Line видна строка файла, которая их закрыла.
Найти ошибку мало — нужно понять, с какой страницы на неё ведёт ссылка. Выделите адрес и откройте внизу вкладку Inlinks: там страницы, с которых ведёт ссылка.
Весь список сразу даёт Bulk Export → Response Codes → Client Error 4XX Inlinks.
В идеале внутренние ссылки ведут прямо на страницы с ответом 200, без редиректов. Что делать с каждой битой ссылкой, мы разбирали в статье как найти битые ссылки и что с ними делать.
Indexability: какие страницы закрыты от индекса
Колонка Indexability на вкладке Internal показывает, разрешено ли поисковику индексировать страницу. Indexable — адрес открыт, отвечает 200 и запрета нет.
Non-Indexable — у адреса есть причина, она в соседней колонке Indexability Status: закрыт в robots.txt, нет ответа, редирект, ошибка 4xx или 5xx, noindex, nofollow, canonical на другой адрес.
Noindex — метка в коде страницы «не показывать её в поиске», nofollow — просьба не переходить по ссылкам.
Нажмите на заголовок колонки Indexability, чтобы Non-Indexable собрались вместе, и ищите среди них страницы, которые должны быть в поиске: услуги, категории, карточки.
Отдельно откройте вкладку Directives, фильтр Noindex — такие адреса создатели программы советуют проверять внимательно.
Page Titles, Meta Description и H1: пустые и одинаковые
На вкладке Page Titles сначала смотрите фильтры Missing (title нет), Duplicate (одинаковый title на разных страницах) и Multiple (на странице несколько title). Это находки, которые обычно стоит исправить.
Фильтр Over 60 characters собирает длинные title: по описанию программы, их может обрезать выдача Google. Это повод посмотреть, а не правило.
Что сканер считает ошибкой зря, мы разобрали в статье как проверить сайт на ошибки за час.
Описания проверяют так же: в Meta Description фильтры Missing и Duplicate покажут пустые и одинаковые, а Over 155 characters — те, что выдача Google может обрезать.
У H1 фильтры те же: Missing, Duplicate, Multiple. Несколько H1 программа не считает явной ошибкой, но советует оставлять один главный заголовок.
Canonicals и дубли страниц
Canonical нужен, когда одна страница доступна по нескольким адресам. На вкладке Canonicals откройте три фильтра:
- Missing — canonical нет совсем;
- Multiple Conflicting — на странице несколько canonical с разными адресами;
- Non-Indexable Canonical — canonical ведёт на закрытый адрес, редирект или ошибку. Его исправляют на рабочую версию страницы.
Одинаковые страницы ищутся во вкладке Content, фильтр Exact Duplicates: программа сравнивает полный код страниц, и это доступно бесплатно. Похожие, но не одинаковые страницы находит только платная версия.
Там же фильтр Low Content Pages — страницы короче 200 слов. Создатели программы сами пишут, что минимального объёма текста нет и фильтр — грубый ориентир. У карточек магазина слов мало, и это нормально.
Images: тяжёлые картинки и alt
В Images фильтр Over 100kb собирает картинки тяжелее 100 КБ — это общий ориентир, какие файлы стоит сжать. Начните с картинок на главной и на страницах услуг.
Фильтры Missing Alt Text и Missing Alt Attribute показывают картинки без описания. Пустой alt="" у декоративной картинки — не ошибка, так и советует справка. Описание нужно картинкам, которые несут смысл.
Вкладка Issues: что значат тип и приоритет
Вкладка Issues — сводка возможных проблем из всех остальных вкладок. У каждой строки есть тип и приоритет, но приоритет программа ставит без знания вашего бизнеса.
| Тип | Что значит | Что делать (совет редакции) |
|---|---|---|
| Issue | Ошибка, которую лучше исправить | Проверить на важных страницах и поставить в задачу |
| Warning | Не обязательно ошибка, но стоит посмотреть | Решить по каждой странице, исправлять или нет |
| Opportunity | Возможность что-то улучшить | Оставить на потом, если нет ошибок |
Приоритет High, Medium или Low показывает возможное влияние. Пример из справки: Directives: Noindex — это Warning, но с приоритетом High. Если noindex стоит по ошибке на нужной странице, ущерб большой.
В справке сказано, что приоритеты — не жёсткие правила и вкладка Issues не заменяет специалиста.
Сама по себе выгрузка из Screaming Frog аудит не заменяет: создатели программы пишут, что без расстановки приоритетов под ваш сайт это ещё не технический аудит.
Мы советуем разбирать так: сначала High на страницах, которые приносят заявки, потом High на остальных, потом Medium. Opportunity — когда ошибки закончились. Все находки разом выгружает Bulk Export → Issues → All.
Как выгрузить находки и передать разработчику
Выгружайте не весь обход, а конкретный фильтр: так разработчик получит список, по которому можно работать. Таблицы выгружаются и в бесплатной версии.
Так и задумано: в описании бесплатного поиска битых ссылок создатели программы предлагают выгрузить ошибки с адресами-источниками и отправить их разработчику сайта.
Сохранить сам файл обхода, чтобы открыть позже, можно только с лицензией.
- Кнопка Export вверху слева выгружает то, что сейчас видно в таблице с выбранным фильтром.
- Данные нижнего окна — Inlinks, Outlinks, Image Details — выгружаются правой кнопкой мыши по адресу.
- Bulk Export в верхнем меню выгружает всё сразу: ссылки на страницы с ошибками 4xx, картинки без alt, все находки Issues.
В задаче разработчику хватит трёх колонок: адрес с ошибкой, страница, где стоит ссылка, и что должно быть вместо неё. Сохраните эту же выгрузку у себя — по ней потом проверите исправления.
Чего Screaming Frog не покажет и где это проверить
Обход показывает сайт таким, каким его видит программа в момент проверки. Попал ли адрес в поиск, как сайт выглядит для Яндекса и какие страницы не связаны ссылками — это видно только в других местах.
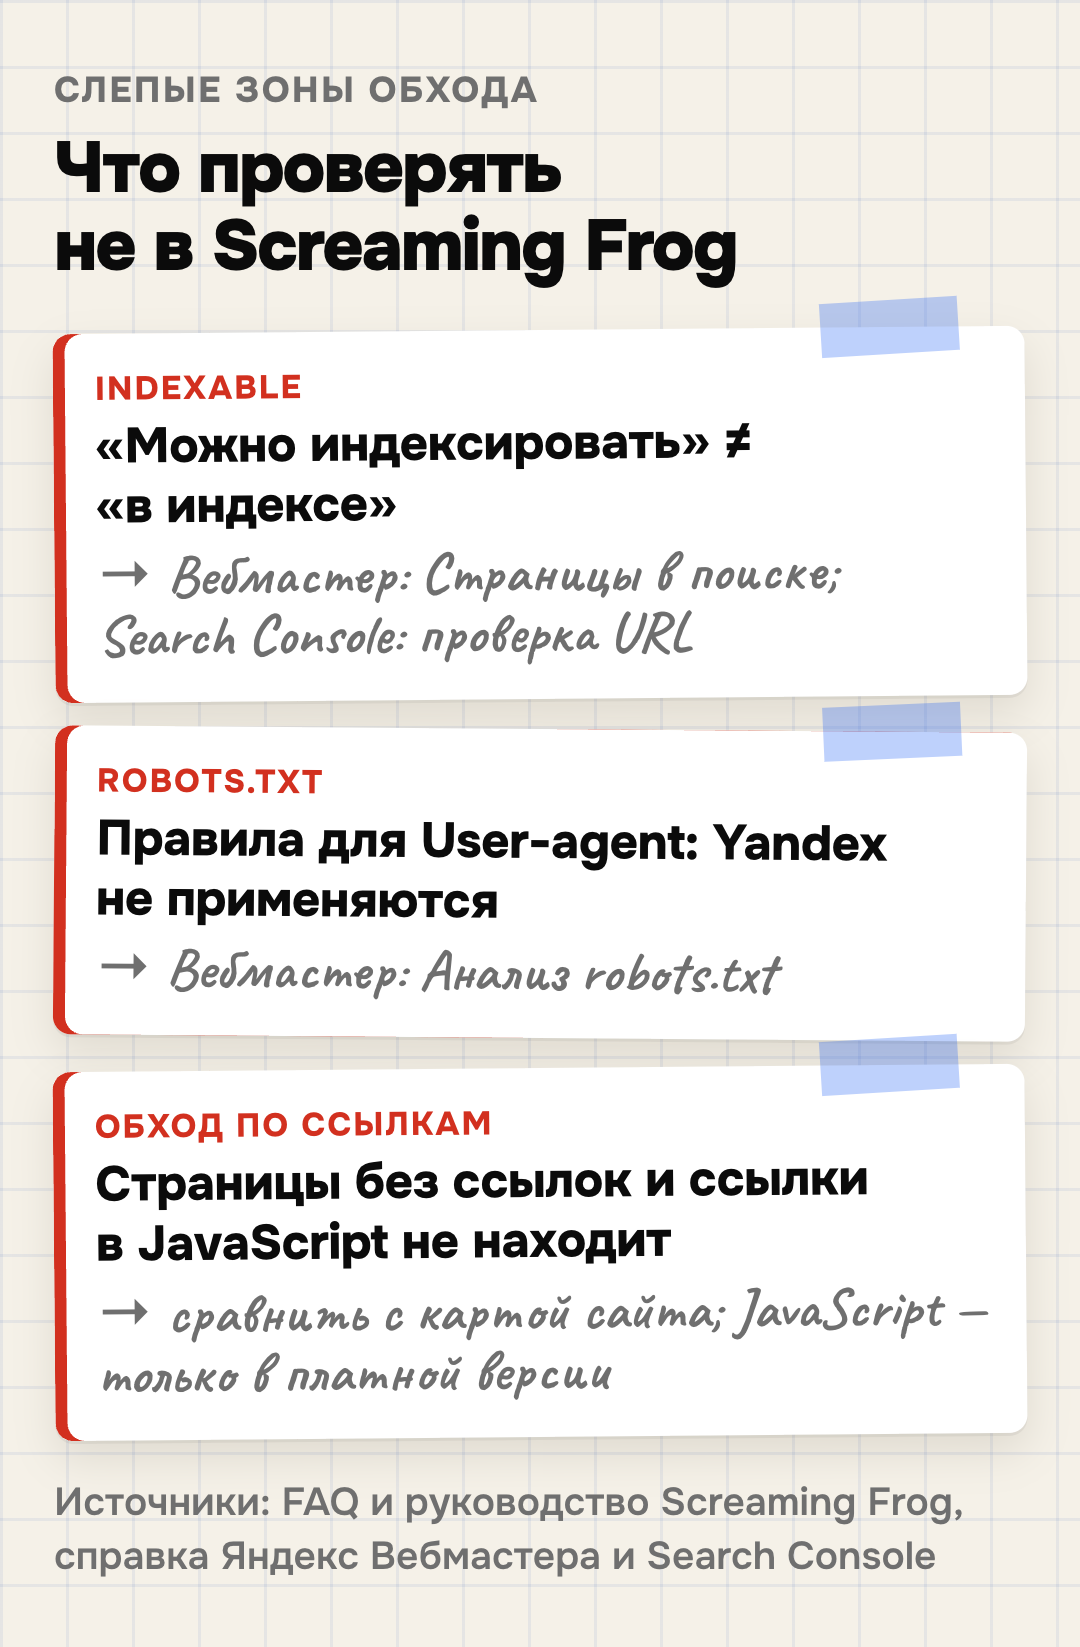
«Можно индексировать» ещё не значит «в индексе»
Indexable в программе описывает ваши указания поисковику, а не решение поисковика. Индексирует ли Google страницу, Screaming Frog не знает — об этом прямо сказано в его справке.
Число страниц в обходе и в индексе тоже не совпадёт: программа видит только внутренние ссылки на момент обхода, а поисковик помнит старые адреса и находит страницы по ссылкам с других сайтов.
В Яндекс Вебмастере откройте Индексирование → Страницы в поиске: там видно, какие страницы в поиске, а какие исключены и почему. В Search Console статус конкретной страницы покажет инструмент проверки URL.
Подробный порядок мы описали в статье как проверить индексацию сайта в Яндексе и Google.
Правила robots.txt для Яндекса
В robots.txt правила записаны секциями: каждая начинается строкой User-agent с именем робота. Screaming Frog читает одну секцию: свою, если её нет — для Googlebot, если нет и её — общую (*). Секцию Yandex он не применяет.
Яндекс тоже читает одну секцию, но свою: если есть User-agent: Yandex, общую (*) он не учитывает. Поэтому результаты расходятся в обе стороны:
- раздел закрыт только в секции Yandex — в обходе он выглядит открытым, хотя Яндекс его не обходит;
- раздел закрыт в общей секции, в секции Yandex открыт, а отдельной секции для Googlebot нет — программа покажет его закрытым, хотя Яндекс его обходит.
Как устроен файл целиком, мы разбирали в статье как настроить robots.txt.
Проверить файл глазами Яндекса можно в Вебмастере: инструмент «Анализ robots.txt» показывает ошибки в файле, а в блоке «Доступ к страницам» можно проверить конкретные адреса. Он работает и для сайта, не добавленного в Вебмастер.
Страницы без ссылок и меню на JavaScript
Страницу, на которую не ведёт ни одна внутренняя ссылка, программа не найдёт: она идёт только по ссылкам, а карту сайта по умолчанию не читает.
Со скриптами похоже. JavaScript по умолчанию не выполняется, и ссылки, которые есть только в скриптах, в обход не попадут. Выполнение JavaScript есть только в платной версии.
Признак такой проблемы — обход нашёл заметно меньше страниц, чем вы ожидали. Сравните число HTML-страниц с картой сайта и с отчётом «Страницы в поиске»: разница покажет, куда смотреть.
Как проверить, что ошибки исправлены
Чтобы проверить исправления, запустите новый обход всего сайта. Повторный обход только страниц, где стояли битые ссылки, не уберёт старые 404 из отчёта: их нужно удалить вручную или обойти сайт заново.
- Убедитесь, что правки опубликованы: откройте страницу в окне инкогнито.
- Если сайт работает через CDN (сеть серверов, которая хранит копии страниц) или с кэшем, попросите разработчика сбросить кэш. У самой программы кэша нет, но старые данные может отдавать кэш сайта.
- Запустите обход с того же адреса, что и в первый раз.
- Выгрузите те же фильтры и сравните с выгрузкой до правок: исчезли ли адреса, ушли ли ошибки.
Режим сравнения двух обходов (Compare) в программе есть, но только с лицензией и при хранении обходов в базе. Для небольшого сайта сравнения двух таблиц вручную хватает.
FAQ: частые вопросы о Screaming Frog
Можно ли Screaming Frog пользоваться бесплатно?
Да, бесплатная версия обходит до 500 адресов за раз, без регистрации. Лицензия за £199 в год снимает лимит и открывает настройки, сохранение обходов и платные функции.
Есть ли у Screaming Frog инструкция на русском?
Русского интерфейса нет: программа работает на английском, испанском, немецком, французском и итальянском. В справке Screaming Frog обзор каждой вкладки дан на английском, а для первой проверки хватит маршрута из этой статьи.
Что делать, если на сайте больше 500 адресов?
Если обход остановился на 500 адресах, возможно, сработал бесплатный лимит: проверьте, попали ли в обход нужные страницы.
Сайт можно обойти по разделам: адрес раздела и Subfolder в переключателе вверху окна. Весь сайт за один обход — только с лицензией.
Не уроню ли я сайт обходом?
По умолчанию программа обходит сайт в 5 потоков, чтобы не перегружать сервер. Перегрузить его можно, если с лицензией сильно поднять число потоков. Время обхода лучше заранее согласовать с тем, кто отвечает за сервер.
Если сайт отвечает ошибкой 429, попросите добавить ваш IP и user-agent программы в разрешённые.
Почему программа нашла меньше страниц, чем есть в поиске?
Она идёт только по внутренним ссылкам на момент обхода, не читает карту сайта и не выполняет JavaScript. Поисковик знает и старые адреса, и страницы, на которые ссылаются другие сайты.
Нужно ли исправлять всё из вкладки Issues?
Нет. В справке сказано, что приоритеты — не жёсткие правила: у программы нет контекста вашего бизнеса. Начните с High на страницах, которые приносят заявки.
Проверка сайта за вечер: четыре шага
- Скачайте бесплатную версию с официального сайта и прогоните сайт с той версии адреса, на которую он открывается.
- Во вкладке Response Codes откройте Client Error (4xx), выгрузите Bulk Export → Response Codes → Client Error 4XX Inlinks и отдайте разработчику.
- Соберите Non-Indexable сортировкой по колонке Indexability и проверьте, нет ли там услуг и категорий. Затем сверьте эти страницы с отчётом «Страницы в поиске» в Вебмастере и проверкой URL в Search Console.
- Посмотрите robots.txt глазами Яндекса. Это умеет бесплатный SEO-аудит PrivateSEO: проверяет правила для Яндекса и Google, запреты индексации, title и H1 до 500 страниц.


