
Индексацию одной страницы проверяют инструментом «Проверка URL» в Google Search Console и инструментом «Проверка страницы» в Яндекс Вебмастере. Каждая панель отвечает только за свой поисковик.
По сайту целиком смотрят два отчёта: «Индексирование → Страницы» в Search Console и «Индексирование → Страницы в поиске» в Вебмастере. Оператор site: в поиске — быстрая прикидка, а не отчёт.
Индексация — это попадание страницы в базу поиска. Пока страницы в базе нет, по запросам она не показывается, и робот при этом мог заходить на неё годами. Обход и индекс — разные состояния.
Ниже — порядок проверки: одна страница, весь сайт, расхождения между цифрами, статусы панелей и то, какую долю страниц в индексе считать нормой.
Коротко.
- Точный ответ по одной странице даёт только инструмент проверки URL. Справка Google прямо пишет: по отчёту «Страницы» статус конкретного адреса определить нельзя.
- Оператор
site:годится как быстрое «да»: адрес нашёлся — он в индексе. Пустой ответ ответом не считают — Google сам пишет, что оператор возвращает не все адреса. - Проверка URL отвечает по сведениям из индекса на дату последнего обхода, а не по текущей версии страницы. Свежие правки появятся в ней только после переобхода.
- Индекс и показы — не одно и то же: по справке Google попадание страницы в индекс не гарантирует, что она появится в результатах поиска.
- Доли считают по одному списку нужных адресов и только по полным данным. В нашем замере 5 октября 2026 Google держал в индексе 129 статей блога из 138, Яндекс — все 138.
Как проверить одну страницу за минуту
Одну страницу проверяют двумя вопросами к двум панелям: Google отвечает в «Проверке URL», Яндекс — в «Проверке страницы». Поисковая строка даёт быстрый, но односторонний ответ.
Порядок ниже — от быстрого способа к точному. Оператор закрывает только половину вопроса: нашёл адрес — страница в индексе есть; не нашёл — вывода пока нет, идите в панель.
Google: оператор, затем Search Console
- Введите в Google
site:и полный адрес страницы:site:. Адрес в ответе — страница в индексе и может показываться.https://example.com/stranica - Пустой ответ на этом не заканчивает проверку: оператор возвращает не все проиндексированные адреса. Вывод «страницы нет в индексе» делают по панели, а не по выдаче.
- Откройте Search Console и вставьте адрес в строку наверху панели — это инструмент «Проверка URL». Он работает только по ресурсу, права на который подтверждены.
- Прочитайте вердикт: «URL есть в индексе Google» или «URL нет в индексе Google». В блоке «Сканирование» — дата последнего обхода, к версии которой относится весь ответ.
- Если адреса в индексе нет, причина написана в том же разделе: запрет в robots.txt, noindex, копия, ошибка ответа или «просканирована, но пока не проиндексирована».
- Там же видно, какой адрес Google считает каноническим. Справка предупреждает: канонический определяется только по индексу, проверка опубликованной страницы его не покажет.
Запрос с оператором предлагает и справка Google: если на сайте меньше 500 страниц, отчёт об индексировании, скорее всего, не потребуется — ключевые адреса проверяют запросами и проверкой URL.
Яндекс: оператор url:, затем Вебмастер
- Введите в Яндексе
url:и адрес страницы. Справка Яндекса просит указывать главный адрес сайта — тот, который выбран основным зеркалом. - Пустой ответ и здесь не вывод, а повод открыть панель: в выдаче страницы может не быть по причинам, к индексу не относящимся.
- Откройте Вебмастер и зайдите в «Индексирование → Проверка страницы». Статус адреса в поиске виден по кнопке «Подробнее», вкладка «Версия страницы в базе».
- Сверьтесь с отчётом «Страницы в поиске»: участвует ли адрес в поиске сейчас и не попал ли он в «Исключённые страницы» — там же написана причина.
- Справка Яндекса предупреждает отдельно: страница может обходиться роботом и при этом в поиске отсутствовать. Обход сам по себе ничего не доказывает.
| Что видно | Что это значит |
|---|---|
| Панель пишет: адрес в индексе | Страница в базе поиска. Показы по запросам это ещё не гарантирует |
| Адреса нет в индексе, обход был | Робот страницу видел и не взял. Причину панель называет рядом: запрет, noindex, копия, ошибка ответа |
| Статус «просканирована, но пока не проиндексирована» | Google страницу скачал, решения в её пользу не принял и причины не называет |
| Адреса нет в индексе, даты обхода нет | Робот до страницы не дошёл: проверьте ссылки на неё и карту сайта |
| Канонической выбрана другая страница | Поисковик считает адрес копией и показывает вместо него выбранный |
| Оператор ничего не нашёл | Это не ответ про индекс: оператор пропускает адреса. Статус смотрят в панели |
Весь сайт проверяют сверкой списка, а не одной цифрой
По сайту целиком одно число ничего не говорит. Считают по одному списку: сколько у вас адресов, которые обязаны быть в поиске, и сколько из них нашлось в индексе каждого поисковика.
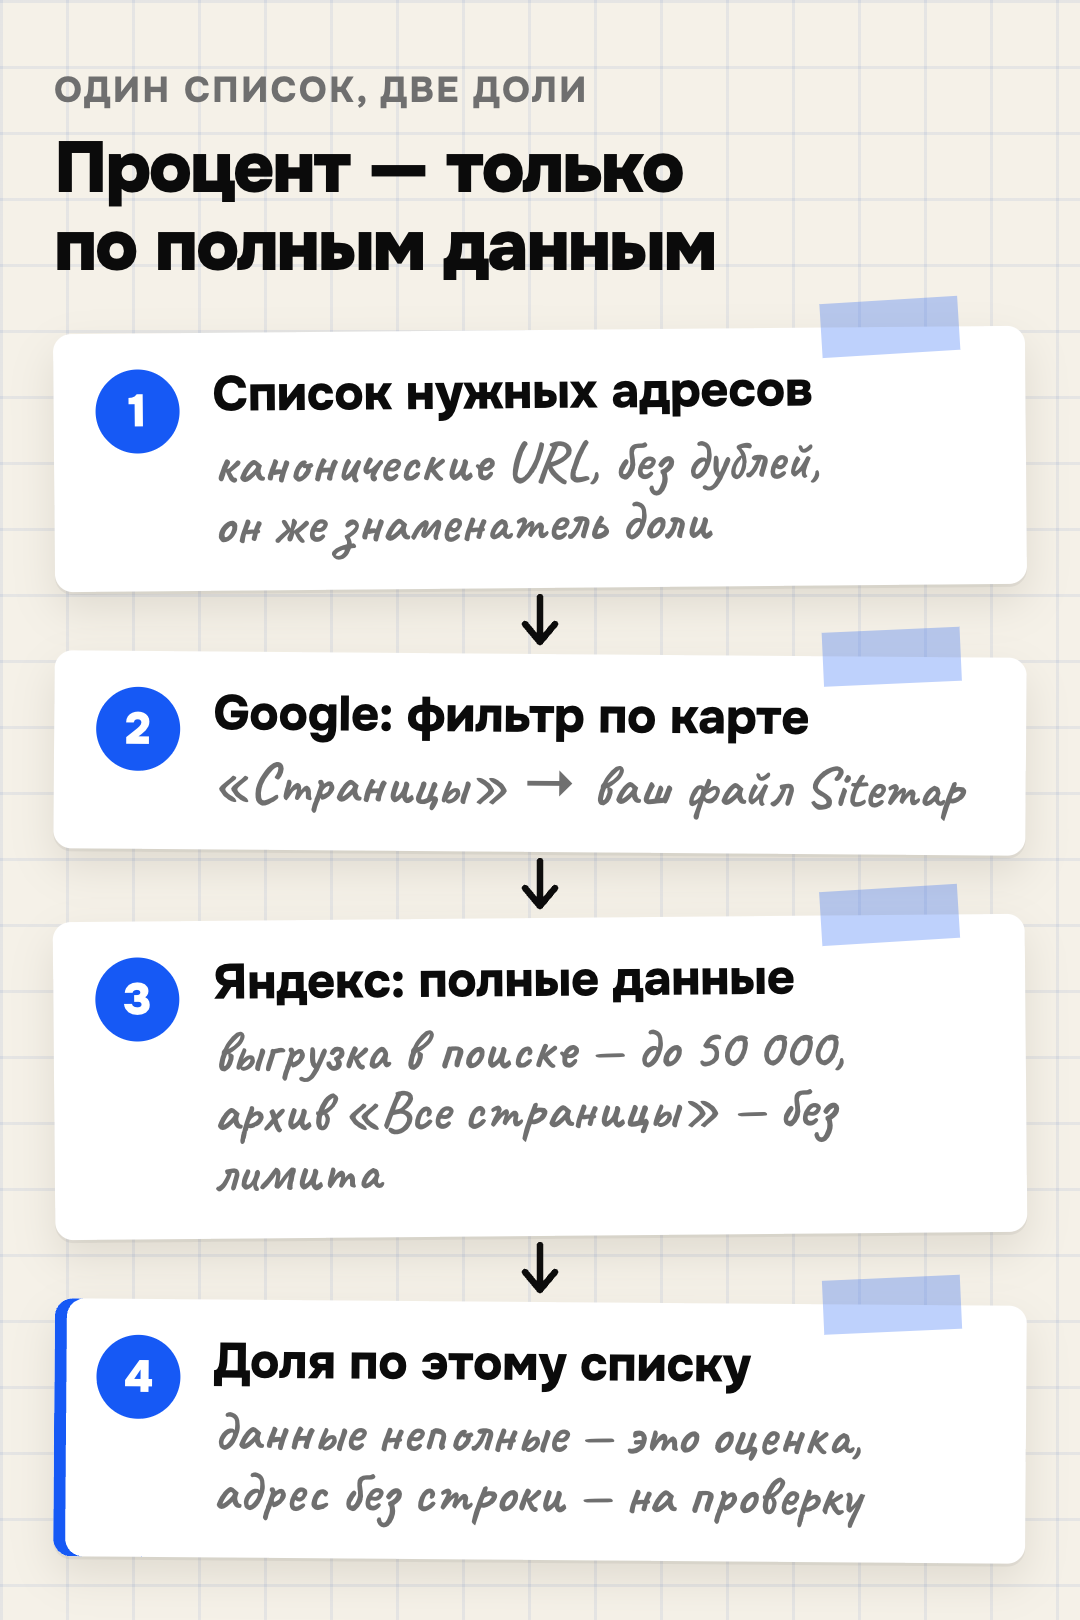
Правило расчёта одно: числитель и знаменатель — одно и то же множество адресов. Общие числа панелей посчитаны по своим множествам, и доля из них выходит завышенной, вплоть до «больше 100%».
- Составьте список нужных адресов — канонических, по одному на страницу. Служебные страницы, фильтры, пагинацию и дубли в него не включают. Это знаменатель и список для сверки.
- Google: отправьте файл Sitemap, в котором только эти адреса, и в меню над диаграммой отчёта «Страницы» выберите его. Такой приём предлагает сама справка Google.
- Фильтр «Все отправленные страницы» считает адреса из всех ваших карт сайта сразу. Для сверки по списку он годится только тогда, когда карта одна и совпадает со списком.
- Яндекс: в «Страницах в поиске» переключитесь на «Все страницы» и выгрузите список в файл. У выгрузки предел — 50 000 адресов, а общее число Вебмастера считает и адреса вне вашего списка.
- Полные данные по вашему списку даёт архив «Индексирование → Все страницы»: справка обещает статистику без ограничений по адресам из вашего файла Sitemap, со статусом каждого адреса в поиске.
- В архиве и смотрят на статус: он стоит у каждого адреса. «Известен Яндексу» и «участвует в поиске» — разное, и в числитель идёт только второе.
- Короткий список проще проверить поштучно: до 100 адресов складывают в «Мониторинг важных страниц» Вебмастера, их же прогоняют по одному через «Проверку URL» в Search Console.
- Доля — это сколько адресов из вашего списка нашлось в индексе, отдельно по Google и по Яндексу. Считают её по полным данным, и дальше работает не процент, а список тех, кто не попал.
Суммы над графиком в Search Console справка Google называет точными и полными с точки зрения Google, но предупреждает: ваша собственная оценка числа страниц может с ними не совпадать.
Точную долю считают только по полным данным для выбранного списка. Если выгрузка упёрлась в предел, архив не собрался или полнота неизвестна — это оценка, а не доля индексации.
И отсутствующий в такой выгрузке адрес не выпавший, а непроверенный. Такие адреса прогоняют поштучно через «Проверку страницы» и «Мониторинг важных страниц» либо добирают полные данные.
Как проверить список адресов, а не одну страницу
Точный способ один: спросить про каждый адрес отдельно. Мы так прогнали 138 статей своего блога через API проверки URL — получился статус из индекса Google по каждому адресу, а не прикидка по выдаче.
У такого статуса своя граница: он относится к последней просканированной версии страницы. Правок, сделанных после обхода, панель ещё не видит — они учтутся при следующем обходе.
У отчётов есть предел: справка Google предупреждает, что список примеров в отчёте об индексировании не бывает длиннее 1000 адресов, и даже при меньшем числе показывает не все.
Большинство онлайн-чекеров и браузерных расширений опрашивает выдачу тем же оператором, что и вы руками. Точнее самой выдачи такой ответ не будет, зато удобно, когда адресов десятки.
С краулерами путаница отдельная. Программа, которая обходит сайт, показывает, какие страницы на нём есть и что они отвечают роботу. Про индекс поисковика она не знает ничего.
Чем обход отличается от индекса и показов
Страница проходит три состояния, и у каждого свой отчёт. Робот её скачал, поисковик взял её в базу, по запросам она показывается — это три разных факта, а не один.
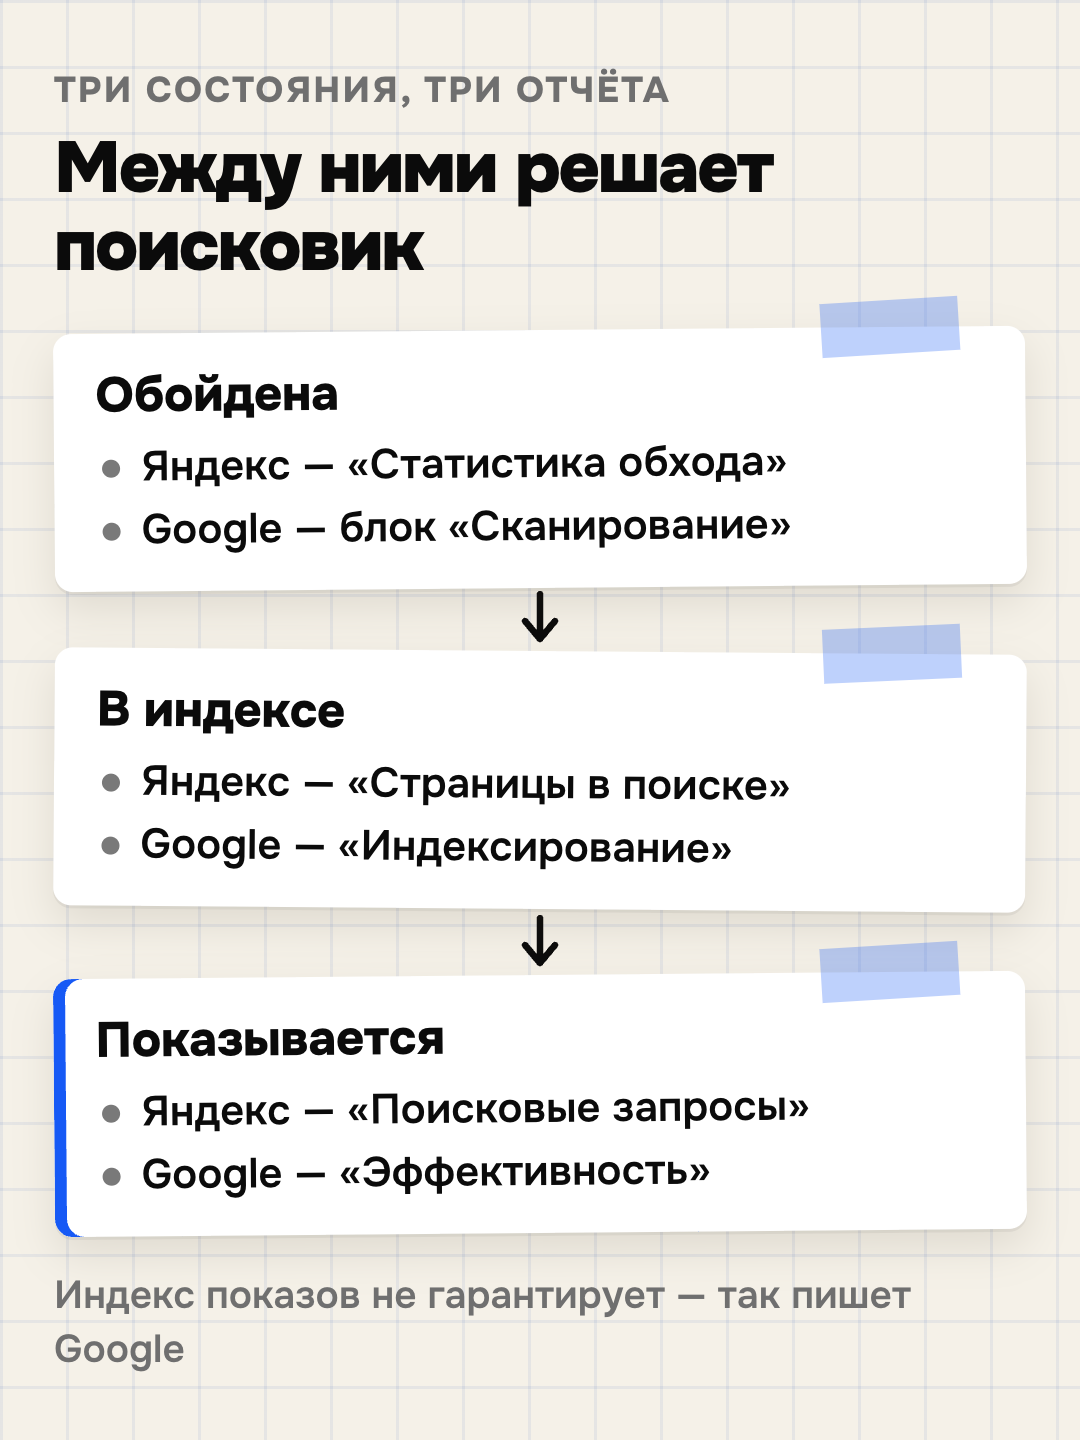
Обход видно в «Статистике обхода» Вебмастера и в блоке «Сканирование» проверки URL в Search Console. Там же дата последнего визита робота и код ответа, который он получил.
Индекс — это уже база поиска: «Страницы в поиске» у Яндекса, «Индексирование → Страницы» у Google. Робот может ходить на страницу месяцами и в индекс её не брать.
Показы — третье состояние: их видно в «Эффективности» Search Console и в «Поисковых запросах» Вебмастера. Справка Google предупреждает прямо: попадание в индекс не гарантирует показ страницы в результатах поиска.
Отсюда правило чтения: «нас нет в поиске по запросу» и «страницы нет в индексе» — разные диагнозы. Первый лечат контентом и ссылками, второй — сначала проверкой доступности.
Почему три числа по одному сайту не сходятся
Три источника дают три разных числа, потому что отвечают на разные вопросы. Оператор показывает выдачу, отчёт — базу Google по вашему ресурсу, проверка URL — сведения по одному адресу.
| Источник | Что показывает | Чего не покажет |
|---|---|---|
Оператор site: | Часть проиндексированных адресов, которые могут показываться | Полный список и точное количество |
| Отчёт «Страницы» в Search Console | Сколько адресов Google взял в индекс, а сколько нет, и по каким причинам | Статус конкретного адреса |
| Проверка URL | Сведения из индекса по одному адресу — на дату его последнего обхода | Картину по сайту и текущую версию страницы |
| «Страницы в поиске» в Вебмастере | Какие адреса участвуют в поиске Яндекса и какие исключены | Что происходит в Google |
У проверки URL два режима, и путать их дорого. Ответ по индексу говорит, что Google знает о странице по последнему обходу; проверка опубликованной страницы — доступна ли она для индексирования сейчас.
Справка формулирует это прямо: со времени последнего сканирования страница могла измениться или быть удалена, а чтобы посмотреть текущую версию, нужна отдельная проверка опубликованной страницы.
Поэтому после правок и релизов проверка опубликованной страницы покажет, что мешает роботу, но присутствия в индексе не подтвердит. А вердикт по индексу о свежих правках ещё не знает.
Ограничения оператора Google описал сам: site: не всегда возвращает все адреса, проиндексированные с указанным префиксом. То есть считать по нему страницы в индексе бессмысленно.
Второе ограничение из той же справки: без поискового запроса оператор не ранжирует результаты. Первым обычно стоит самый короткий адрес, остальные идут почти случайно.
И третье: оператор сделан для людей, которые ищут, а не для владельцев сайтов. Отсюда вывод — для быстрого «да» по одному адресу он годится, для подсчёта страниц нет.
А вот с запросом оператор полезен: site:example.com плюс слово показывает, какие страницы сайта могут показываться по этому слову. Так же ищут и мусор, попавший в индекс.
Что означают статусы и что делать
Статус в панели объясняет, что происходит с адресом: взят он в индекс или нет и почему. Разбирают статусы группами — часть причин нормальна, и трогать их не нужно.
| Статус | Что значит | Первый шаг |
|---|---|---|
| Страница просканирована, но пока не проиндексирована | Google страницу скачал и в индекс не добавил; по справке она может попасть в индекс позже, а может остаться как есть | Сверить дату обхода, затем сравнить содержание с тем, что стоит в топе по её запросу |
| Обнаружена, не проиндексирована | Адрес найден, но сканирование отложено — по справке, чтобы не перегрузить сайт | Проверить скорость ответа сервера и ссылки на страницу |
| Страница с переадресацией | Адрес ведёт на другой: в индекс попадёт конечная страница, а не этот URL | Обычно норма: проверить, что переадресация ведёт куда надо |
| Страница является копией | Канонической Google выбрал другую версию, и копия в результатах не показывается | Посмотреть в проверке URL, какой адрес выбран каноническим |
| Доступ к URL заблокирован в robots.txt | Сканирование адреса запрещено вашими же правилами | Открыть robots.txt и проверить, не закрыто ли лишнее |
| Страница содержит директиву noindex | Робот увидел запрет в коде или заголовке ответа и остановился | Найти директиву в шаблоне: её часто забывают после разработки |
| Не найдено (404) | Страницы по адресу нет. Если её удалили без замены, справка Google считает это нормой | Нужная — вернуть, переехавшая — отправить переадресацией 301 |
| Что видно | Что значит | Первый шаг |
|---|---|---|
| Адрес в «Страницах в поиске» | Страница участвует в поиске Яндекса | Проверить заголовок и описание, с которыми она показывается |
| Исключена: «Малополезный контент» | Фильтр Яндекса: страница признана малополезной | Разобрать, чем страница полезна читателю, и усилить её |
| Исключена: редирект или дубль | Адрес склеен с другим, в поиске участвует он | Обычно норма: убедиться, что в поиске остался нужный адрес |
| Исключена: ошибка или запрет | Сервер ответил ошибкой либо адрес закрыт от робота | Проверить код ответа сервера и правила robots.txt |
| Адреса нет в списке «Статистики обхода» | Вывода из этого не делают: список — до 50 000 адресов, обновляется с задержкой и зависит от фильтров | Снять фильтры и выбрать весь сайт, затем проверить адрес в «Проверке страницы» |
«Первый шаг» здесь — именно диагностика, а не разгон индексации. Как подталкивать робота после того, как причина найдена, разобрано отдельно: как ускорить индексацию.
Про статус «просканирована, но пока не проиндексирована» справка Google говорит прямо: страница может попасть в индекс позже, а может остаться как есть, и заново запрашивать сканирование не нужно.
Санкцией этот статус не считается, и причину он не называет. В нашем замере 5 октября в нём лежали все 9 статей, которых Google не взял. Как мы его разбираем — в статье про санкции Google.
Наш замер: Google держит 129 статей из 138, Яндекс — все
Мы прогнали все 138 статей своего блога поштучно: гугловский статус каждого адреса — через API проверки URL, яндексовский — по отчёту «Страницы в поиске». В Google оказалось 129 статей, в Яндексе — все 138.
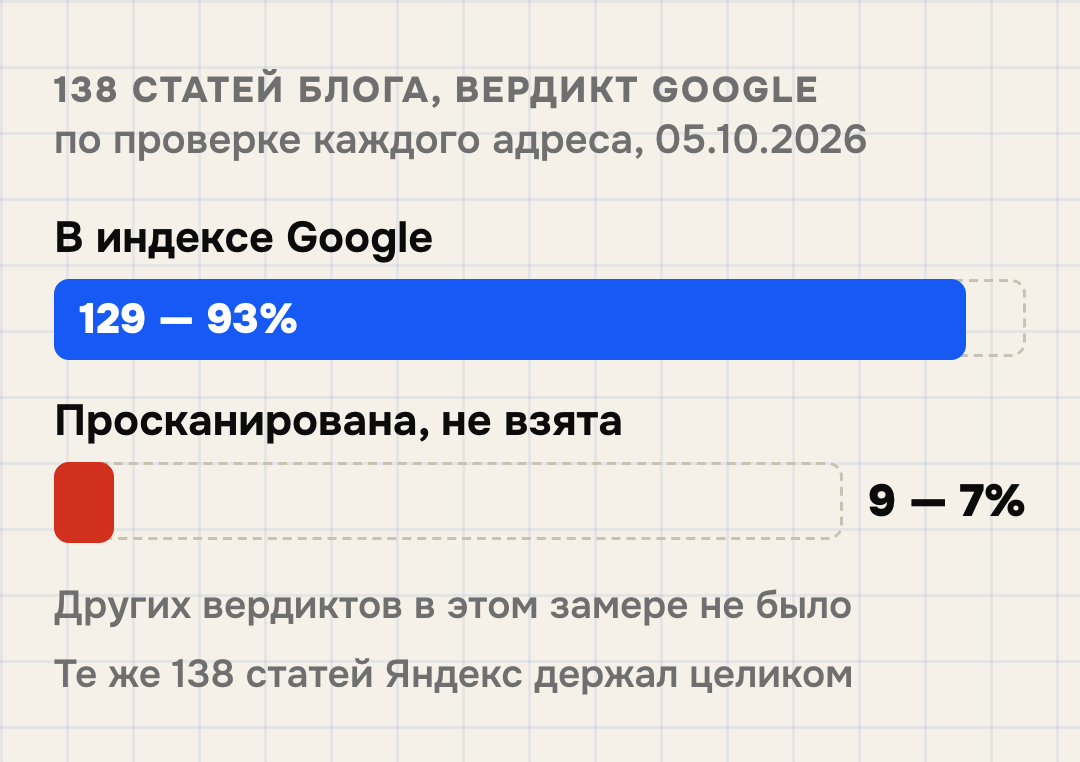
Остальные 9 адресов лежат в статусе «просканирована, но пока не проиндексирована»: Google их скачал и в индекс не взял. Других вердиктов в этом замере не было.
Это наш собственный блог, а не срез рунета, и замер пересчитывается каждую неделю: цифры выше — на 5 октября 2026. Методика и свежие числа лежат в исследовании индексации Google.
Практический вывод для проверки: сводить «страницы в индексе» двух поисковиков к одному числу нельзя. Решения по каждому адресу они принимают сами, и доли считают порознь.
И потери в Google стоят дорого: по нашему замеру на 14 сайтах малого бизнеса Google приносил в среднем 48,6% органического трафика — данные на 5 октября 2026.
Как часто проверять и что считать нормой
Норма — не 100% адресов в индексе, а все страницы, которые приносят деньги. Похожее пишет и справка Google: на большинстве сайтов часть страниц остаётся непроиндексированной, но ключевые должны быть обработаны.
Поэтому проверку начинают со списка: главная, услуги или категории, карточки-локомотивы, свежие статьи. Если они в индексе обоих поисковиков, общая доля вторична.
Частота — наша рекомендация редакции, а не требование поисковиков. Новый сайт стоит смотреть раз в неделю первый месяц, дальше — раз в месяц, и каждый раз после переезда, смены шаблона или крупного релиза.
Отдельно смотрят на динамику: график в обоих отчётах показывает, как число страниц в индексе меняется. Резкий провал разбирают по списку исключённых адресов в тот же день.
Два способа «проверить индексацию», которые ничего не проверяют: поиск по фрагменту текста и запрос с названием компании. Фрагмент может не найтись и у страницы в индексе, а главная в поиске ничего не говорит про остальные адреса.
FAQ: частые вопросы о проверке индексации
Что значит «Страница просканирована, но пока не проиндексирована»?
Google страницу скачал и в индекс не добавил. По справке она может попасть в индекс позже, а может остаться в этом состоянии; заново запрашивать сканирование не нужно.
Причину статус не называет: смотрят дату обхода и сведения в проверке URL. В нашем замере 5 октября в этом статусе лежали 9 статей блога из 138 — все, которых Google не взял.
Почему в Яндексе 500 страниц в индексе, а в Google 50 (пример)?
Это два независимых индекса, и решение по каждой странице они принимают сами. Разные числа — норма, одной «правильной» цифры по сайту не существует.
Размер разрыва у каждого сайта свой: на нашем блоге 5 октября Яндекс держал все 138 статей, Google — 129. Доли считают по каждому поисковику отдельно, по одному списку адресов и только по полным данным.
Сколько ждать индексации новой страницы?
По справке Google до сканирования и индексирования новой страницы может пройти неделя. Если через неделю её нет в индексе, можно запросить сканирование.
Заявка не гарантирует ни срок, ни попадание в индекс: справка пишет о сроке от нескольких дней до нескольких недель. Дальше сверяют дату обхода и статус адреса.
Как проверить индексацию без доступа к панели вебмастера?
Остаётся поисковая строка: site: с полным адресом в Google и url: с адресом в Яндексе. Адрес нашёлся — он в индексе, это надёжный ответ.
Пустой ответ ничего не доказывает: Google сам пишет, что все проиндексированные адреса оператор не возвращает. Без панели такой результат остаётся неподтверждённым.
Сколько страниц должно быть в индексе?
Столько, сколько у вас страниц, которые должны приводить людей из поиска. Служебные адреса, фильтры и пагинацию в эту цифру не считают.
Если на сайте меньше 500 страниц, отчёт об индексировании, по справке Google, скорее всего, не потребуется: хватит проверки ключевых адресов.
Как понять, что страница вылетела из индекса?
Сравнить два состояния: раньше адрес был в «Страницах в поиске» или в индексе Google, сейчас его там нет, а показы по его запросам упали до нуля.
Причину ищут в списке исключённых адресов: редирект и склейка — норма, 404, запрет в robots.txt и фильтр — повод разбираться.
Что проверить сегодня
- Выпишите 5–10 адресов, которые обязаны быть в поиске: главная, услуги или категории, две-три страницы с деньгами, последняя публикация.
- Прогоните их по одному через «Проверку URL» в Search Console и «Проверку страницы» в Вебмастере — это десять коротких проверок.
- Сверьте список с индексом: в Google — отчёт «Страницы» с фильтром по вашей карте сайта, в Яндексе — архив «Все страницы», собранный по ней же. Долю считайте по полным данным.
- Разберите статусы непроиндексированных адресов по таблицам выше и отделите норму (редиректы, канонические копии) от проблем.
- Если адрес не в индексе, начните с того, что робот получает по этому адресу: код ответа и цепочку редиректов покажет наш бесплатный инструмент проверки ответа сервера.


