
Видимость бренда в нейросетях измеряют долей ответов, в которых ассистент называет вашу компанию. Берут фиксированный список вопросов покупателя, задают их нескольким моделям, записывают каждый ответ и считают доли.
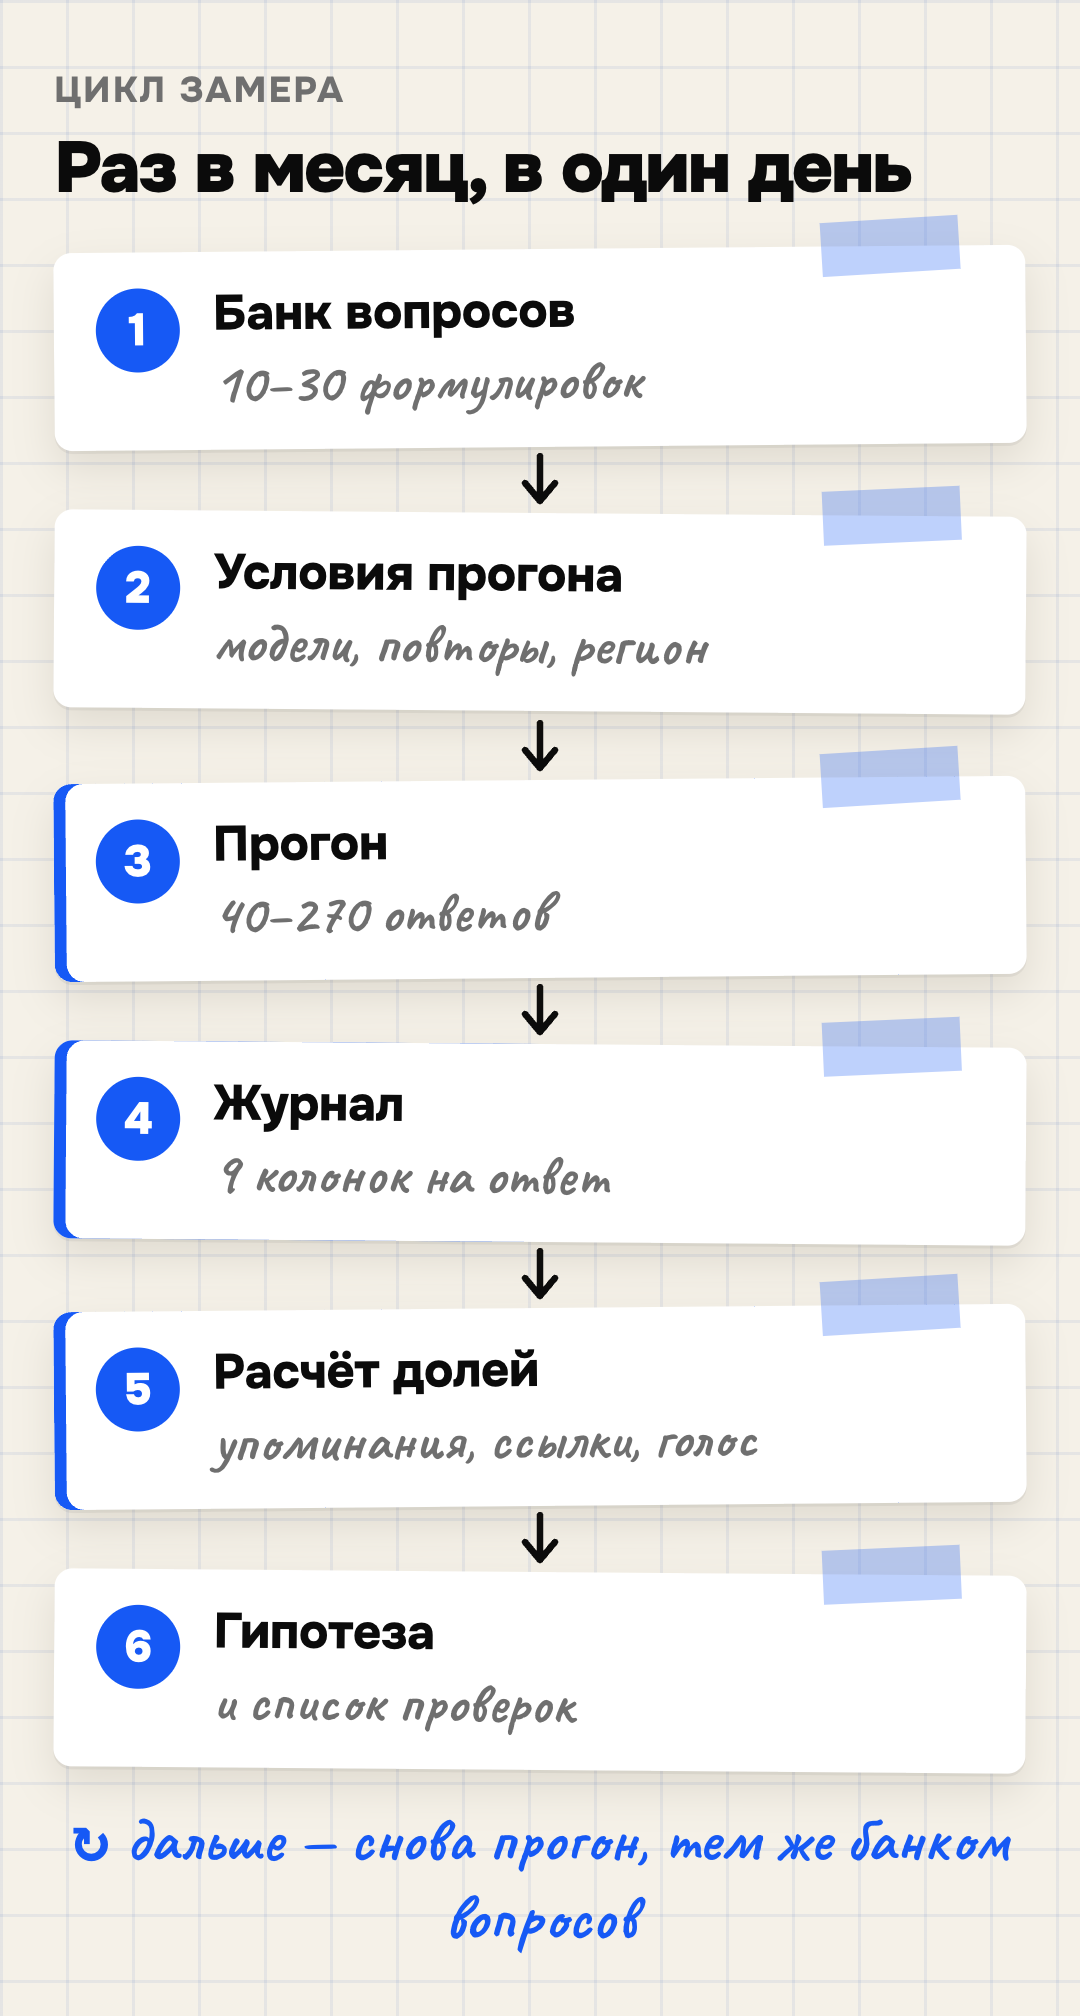
Замер повторяют раз в месяц тем же списком — иначе сравнивать нечего. Одного вопроса в ChatGPT для этого не хватает: ответ собирается заново при каждой генерации, и по одной попытке не видно ни правила, ни динамики.
Ниже — методика целиком: как собрать банк вопросов, в каких условиях прогонять, что записывать по каждому ответу, по каким формулам считать и что делать с полученной цифрой.
Коротко.
- Видимость в нейросетях — это доля ответов, где названа ваша компания, по фиксированному банку вопросов покупателя. Не позиция и не трафик.
- По трафику видимость не измерить: в нашем замере на 13 сайтах нейросети дали 105 визитов за 90 дней — 0,14% поискового трафика, и половина пришла на главную.
- Упоминание бренда и ссылку на сайт считают порознь. В нашем прогоне из 90 ответов магазин не назван ни разу, а ссылку на его страницу нейросеть дала один раз.
- Базовый замер — 10 вопросов, две модели, два повтора: 40 ответов, и шаг шкалы тут 2,5 процентных пункта. По одному новому упоминанию о росте судить нельзя.
- Часть картины отдают панели поисковиков: Вебмастер даёт долю ответов Алисы AI с сайтом в источниках, Search Console — показы ссылок в ИИ Google. Оба про ссылки, не про бренд.
Что считают видимостью бренда в нейросетях
Видимость бренда в нейросетях — доля ответов ассистента, в которых названа ваша компания, посчитанная по заранее заданному списку вопросов. Это та же логика, что у доли показов в поиске, только вместо выдачи — текст ответа.
Отличие от позиции принципиальное. Выдачу поиска можно воспроизвести снимком: фиксируете регион, язык, устройство и персонализацию — и получаете сопоставимый результат, хотя у разных людей он различается.
Ответ нейросети так не зафиксировать. Он собирается в момент обращения, и даже в одних условиях текст каждый раз другой: к различиям поиска добавляется генеративная вариативность самой модели.
Поэтому видимость — всегда статистика, а не факт. Единица замера тут не запрос, а ответ: один вопрос, заданный трём моделям по два раза, даёт шесть ответов и шесть строк в журнале.
Цифра нужна, чтобы выбрать, куда вкладываться: в сайт, в упоминания на чужих площадках или в исправление фактов о компании. Журнал при этом даёт не диагноз, а гипотезу — её ещё нужно проверить.
Почему трафик из нейросетей этого не покажет
Канал пока слишком мал, чтобы быть измерителем. По нашему замеру на 13 сайтах малого и среднего бизнеса нейросети дали 105 визитов за 90 дней против 76 668 из поиска — 0,14% поискового трафика.
Это данные на 7 августа 2026 года, окно — 90 дней. Канал растёт, но до масштаба, на котором по нему можно оценивать видимость, ему далеко.
Из этих переходов 76% привёл ChatGPT и 19% — Perplexity. Половина пришла на главную страницу, в блог — около 12%: нейросети чаще рекомендуют компанию целиком, а не конкретную статью.
К тому же сегмент занижен по устройству замера. Переходы считаются по рефереру, а часть визитов из приложений ассистентов приходит без него и попадает в «Прямые заходы». Насколько именно занижен — по самому сегменту не посчитать.
Отсюда и смысл ручного замера: он смотрит на то, что происходит до клика, и не зависит от того, довёл ли ассистент человека до сайта.
Пять величин замера, которые нельзя складывать
Складывать величины замера между собой нельзя: они считаются по разным выборкам и отвечают на разные вопросы. А в слово «видимость» обычно сваливают сразу все пять.
| Величина | Что считает | Чего не показывает |
|---|---|---|
| Упоминание бренда | В какой доле ответов названа компания | Рекомендуют её или приводят как пример неудачи |
| Цитирование сайта | В какой доле ответов есть ссылка на ваши страницы | Попал ли бренд в сам текст рекомендации |
| Доля в ответах Алисы AI | Долю ответов Алисы AI, где сайт попал в источники, — по запросам, где он и так высоко в выдаче | Показы и клики: Вебмастер их здесь не считает |
| Показы ссылок в ИИ Google | Сколько раз ссылку на сайт показали в Обзорах от ИИ и Режиме ИИ | Что происходит в ChatGPT, Perplexity и других ассистентах |
| Визиты из ассистентов | Сколько людей перешло на сайт из ответа | Сколько увидели бренд и не перешли |
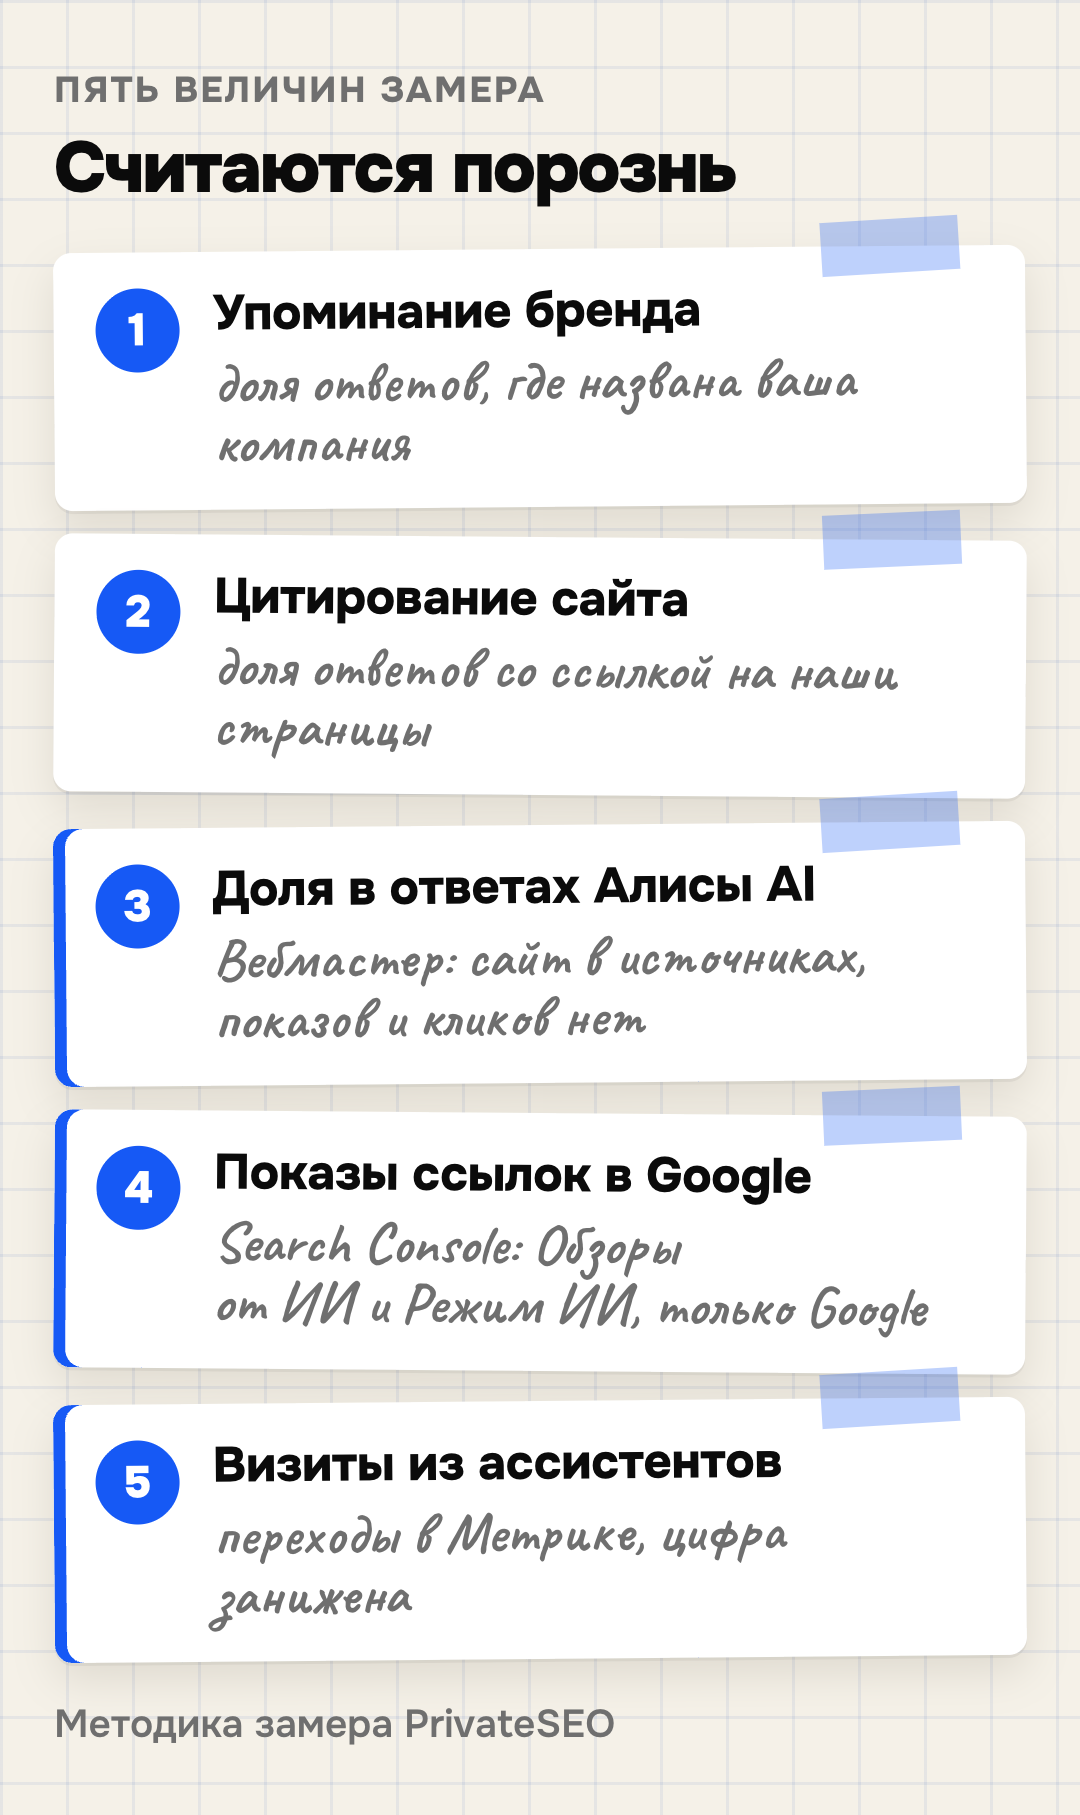
Третья и четвёртая — разные метрики, а не одна «панельная». У Яндекса это относительная доля на своей выборке запросов, у Google — счётчик показов ссылок. Складывать или сравнивать их между собой нельзя.
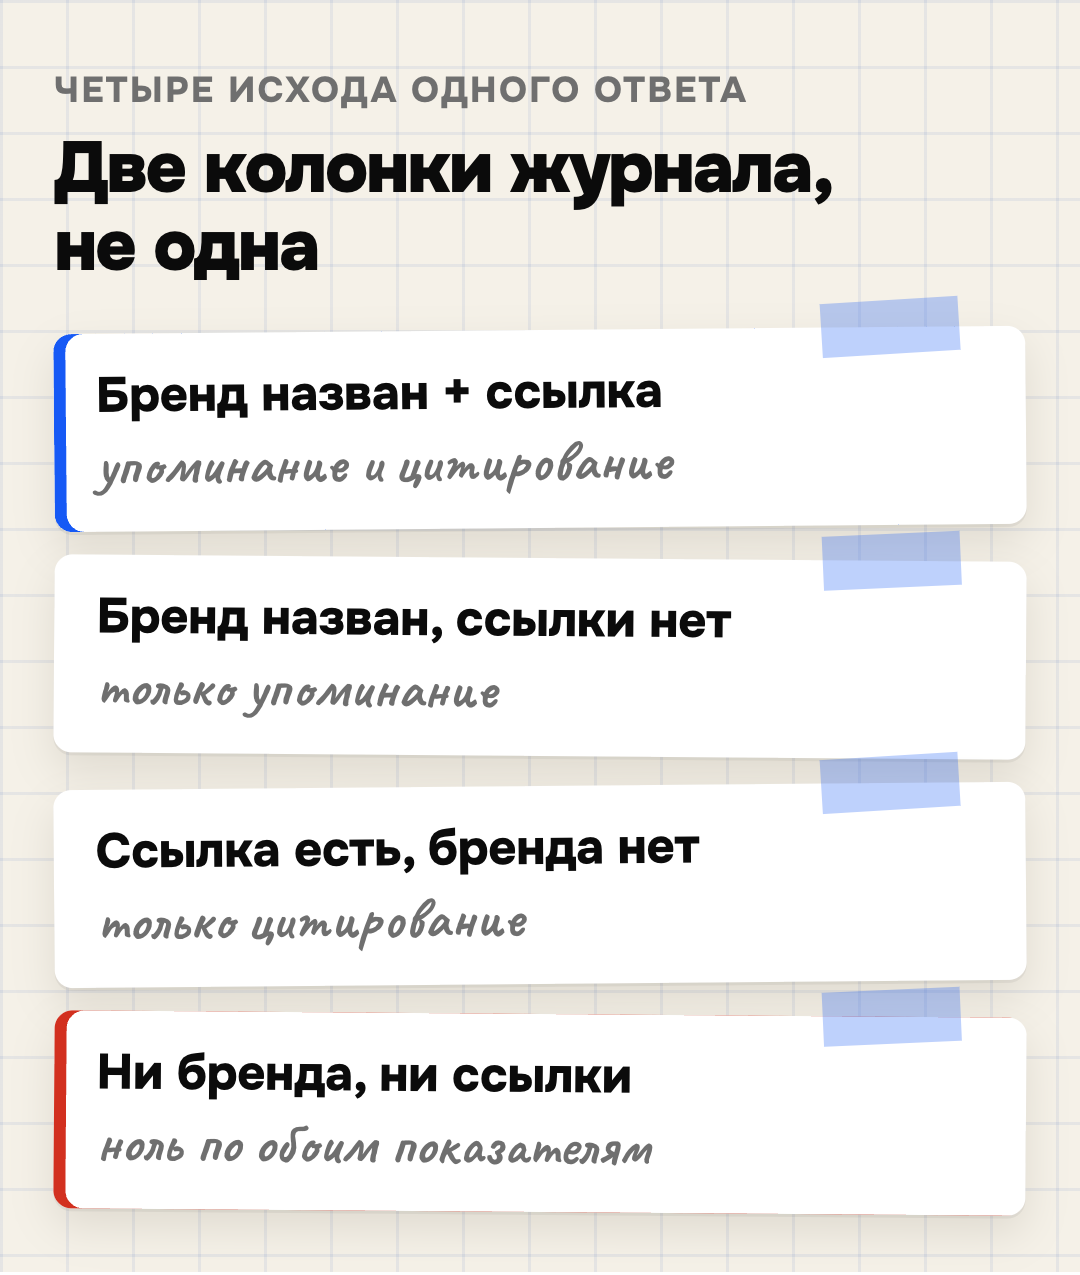
Разводить упоминание и цитирование нужно жёстко. Ассистент может взять статью из вашего блога в источники, а порекомендовать при этом конкурента — ссылка есть, упоминания нет.
Бывает и обратное: компанию называют, а ссылаются на независимый рейтинг или карточку в справочнике. Если слить эти два показателя в один, потом не понять, что именно изменилось.
Про панели поисковиков и сегмент по рефереру в Метрике у нас есть отдельный разбор — в гайде по GEO- и AEO-оптимизации. Здесь дальше — только ручной замер по ответам.
Шаг 1. Банк вопросов покупателя
Банк вопросов — это список формулировок, которые ваш покупатель действительно набрал бы в чате. Его собирают один раз, фиксируют и больше не трогают: сменили список — потеряли возможность сравнить месяцы.
Главное правило: в вопросе не должно быть названия вашей компании. По брендовому запросу человек уже знает, что вы существуете, и такой ответ не говорит о том, может ли ассистент познакомить вас с новой аудиторией.
Источник формулировок — не фантазия, а ваши же разговоры с клиентами: вопросы менеджеров по телефону, переписка в чате на сайте, письма с запросом цены. Их переписывают так, как человек спросил бы у ассистента.
| Группа | Как звучит вопрос | Что проверяет |
|---|---|---|
| Выбор исполнителя | «Посоветуй, кому заказать [услуга] в [город]» | Попадаете ли вы в короткий список |
| Выбор решения | «Что лучше для [задача клиента]» | Называют ли вас на этапе, когда выбирают подход |
| Сравнение | «[Конкурент А] или [конкурент Б]: что выбрать» | Входите ли вы в сравнение вообще |
| Проблема | «Как решить [типовая проблема клиента]» | Цитируют ли ваши материалы как источник |
| Репутация | «Что известно о компании [ваше название]» | Что ассистент вообще знает о вас и откуда |
Группа «репутация» — единственная, где название компании уместно. В общий знаменатель эти вопросы не входят: они измеряют не видимость, а полноту и правдивость того, что модель о вас помнит.
Поэтому репутационные вопросы добавляют сверх основного банка и ведут по ним отдельную таблицу. Когда ниже говорится «10 вопросов», имеются в виду вопросы без названия компании.
Объём банка выбирают по запасу сил, а не по красоте. Базовый вариант — 10 вопросов, расширенный — 30. Географию и продукт подставляют в формулировку: «в Казани», «для небольшой клиники», «для интернет-магазина одежды».
Ориентир редакции: формулировок в банке должно хватать, чтобы на каждую группу приходилось минимум два вопроса. Иначе один неудачный вопрос перекосит весь результат.
Шаг 2. Прогон: модели, повторы и условия
Прогон — это механическое дело: открыть ассистента, задать вопрос из банка, скопировать ответ в журнал, повторить. Смысл в условиях, которые нужно одинаково соблюсти в этот месяц и в следующий.
Порядок действий на один вопрос:
- Откройте новый чат — не продолжение старого.
- Вставьте вопрос из банка дословно, без уточнений и без «а вот ещё».
- Дождитесь полного ответа и скопируйте его в журнал целиком, вместе со списком источников.
- Запишите дату, модель и был ли включён поиск по интернету.
- Закройте чат и откройте новый для следующего повтора.
| Условие | Почему так |
|---|---|
| Новый чат на каждый вопрос | В одном чате модель опирается на предыдущие ответы и начинает подыгрывать |
| Память о прошлых разговорах отключена | Иначе вы измеряете не видимость бренда, а то, что ассистент запомнил про вас лично |
| Режим поиска по интернету одинаковый | С поиском и без него ответы собираются из разных данных, и доли несопоставимы |
| Один регион и язык | Ответ зависит от того, откуда пришёл запрос; смешивать Москву и Казань нельзя |
| Два-три повтора одного вопроса | Ответ генерируется заново каждый раз, по одной попытке правила не видно |
Три условия из таблицы сами собой не выставятся, поэтому с ними разбираются до первого прогона.
- Память и история. Отключите их в настройках ассистента. Если выключателя нет, прогоняйте во временном чате или без входа в аккаунт — и запишите в журнал, как именно.
- Аккаунт. Часть ассистентов отвечает только после входа. Заведите один рабочий аккаунт под замер и не задавайте с него другие вопросы, иначе история начнёт подмешиваться в ответы.
- Регион. Зафиксируйте способ подключения: либо всегда без VPN, либо всегда через одну и ту же страну. Город добавляйте словами в сам вопрос, а не настройками.
Моделей берут минимум две, и желательно разного происхождения: одну зарубежную и одну российскую. По нашим данным, переходы дают в основном ChatGPT и Perplexity.
Но российский покупатель спрашивает ещё Алису, Нейро, GigaChat и DeepSeek, а переходов оттуда Метрика почти не показывает — тем важнее увидеть эти ответы руками.
Арифметика объёма простая. Базовый замер — 10 вопросов × 2 модели × 2 повтора = 40 ответов. Расширенный — 30 × 3 × 3 = 270 ответов.
По нашему ориентиру, базовый замер руками укладывается в вечер, расширенный растягивается на несколько рабочих дней — и это повод подумать про инструмент.
Заранее договоритесь с собой о спорных случаях, иначе второй замер окажется несравнимым с первым. Правила простые, но записать их нужно до начала.
- Бренд назван без ссылки — упоминание есть, цитирования нет.
- Назван домен текстом, но ссылки в источниках нет — упоминание есть, цитирования нет.
- Бренд в списке из десяти наравне со всеми — упоминание, позиция по порядку в списке.
- Бренд назван в минусах или в сравнении не в его пользу — упоминание с пометкой «негатив».
- Ассистент отказался отвечать — строка в журнале с пометкой «отказ», в расчёт долей не идёт.
Шаг 3. Журнал замера: что записывать по каждому ответу
Журнал — обычная таблица, по строке на каждый ответ. Записывать нужно то, что потом не воспроизвести: тот же вопрос в новом чате даст другой текст, а через месяц вы не вспомните, какая модель что сказала.
Что заводить по каждому ответу:
- Дата и модель — вместе с номером повтора и тем, был ли включён поиск по интернету.
- Вопрос — номер из банка, а не пересказ.
- Бренд назван — да или нет.
- Позиция в списке — какой по порядку, если ассистент перечисляет компании.
- Роль упоминания — рекомендация, нейтральное упоминание, негатив или фактическая ошибка.
- Ссылка на наш сайт — да или нет, и какая именно страница.
- Кто ещё назван — все бренды из ответа, через запятую.
- Источники — домены из списка под ответом.
- Доказательство — скриншот или ссылка на сохранённый чат.
Роль упоминания важнее, чем кажется. Компанию могут назвать в перечне «кого лучше обходить» — формально упоминание есть, а для бизнеса это минус, и в отчёте такие строки нужно видеть отдельно.
Без списка «кто ещё назван» вы получите только свою цифру и не поймёте, много это или мало в вашей нише. Это же заготовка для расчёта доли голоса.
Колонка «источники» показывает, из чего ассистент собирает ответ. В нашем прогоне по магазину техники набралось 418 источников на 90 ответов.
Больше всего дали каталоги и маркетплейсы — 122 адреса, карты и справочники — 117, обзоры и рейтинги — 78. Обычных статей среди источников всего 28.
Шаг 4. Как посчитать показатели
Из журнала считают четыре доли, и знаменатель у них не один общий. Две считают от числа ответов, а не вопросов: в базовом замере это 40 против 10, в расширенном — 270 против 30. У двух других знаменатель свой.
Зачтённый ответ — ответ по существу. Отказы ассистента в знаменатель не входят: их считают отдельной строкой, иначе доля поползёт сама по себе.
- Доля упоминаний = ответы с названием компании ÷ зачтённые ответы × 100%.
- Доля ответов со ссылкой = ответы со ссылкой на наш сайт ÷ зачтённые ответы × 100%.
- Доля голоса = упоминания нашего бренда ÷ упоминания всех названных брендов × 100%.
- Доля рекомендаций = ответы с ролью «рекомендация» ÷ ответы с упоминанием нашего бренда × 100%.
Если считать долю голоса от числа ответов, суммы по всем брендам перевалят за 100%: в одном ответе ассистент называет сразу несколько компаний. Поэтому знаменатель здесь — упоминания.
Средняя позиция в списке считается только по тем ответам, где бренд назван. Если из 40 ответов упоминаний четыре (пример), средняя позиция считается по четырём, и говорить о тенденции рано.
Пример расчёта доли голоса на условных цифрах: в 40 ответах ваш бренд назван 6 раз, а всего по этим ответам ассистенты назвали 95 компаний. Доля голоса — 6 ÷ 95, то есть 6,3% (пример).
Нулевой знаменатель: что писать вместо цифры
«0%» и «не рассчитывается» — разные записи. Первая значит, что показатель посчитан и упоминаний не нашлось. Вторая — что делить было не на что. В отчёте их не смешивают.
- Наш бренд не назван ни разу. Доля упоминаний — 0%, доля ответов со ссылкой считается как обычно, а доля рекомендаций не рассчитывается: её знаменатель пуст.
- Ассистенты не назвали никаких брендов вообще. Доля голоса не рассчитывается — ни одного упоминания в выборке нет, делить не на что.
- Все ответы — отказы. Зачтённых ответов ноль, не рассчитывается ни одна из четырёх долей. В журнале остаётся только число отказов за этот замер.
Пустая графа в отчёте честнее нуля: «не рассчитывается» видно глазами, а подставленный 0% через месяц прочитают как наблюдение и поставят в динамику.
Шаг шкалы: откуда берётся 2,5 пункта
Шаг наблюдаемой доли — это 100 ÷ число зачтённых ответов. На 40 зачтённых ответах он равен 2,5 процентных пункта, на 90 — около 1,1, на 270 — 0,37. Промежуточных значений на такой шкале нет.
2,5 пункта получаются ровно при 40 зачтённых ответах. Если ассистенты отказали четыре раза, зачтённых 36 и шаг уже 2,8 — поэтому шаг пересчитывают на каждый замер, а не берут из прошлого отчёта.
Это арифметика шкалы, а не оценка достоверности. «Выросли с 5% до 7,5%» на 40 ответах — ровно одно новое упоминание, и по нему нельзя уверенно судить о росте: различие может быть случайным.
Обратное тоже неверно: скачок побольше сам по себе не становится доказанным ростом. Чтобы отделить изменение от разброса, долю оценивают с интервалом неопределённости или смотрят направление на нескольких замерах.
Повторы по одним и тем же вопросам и смесь моделей — не независимые одинаковые испытания, поэтому готовая формула для доли здесь только ориентир. Чтобы шкала стала мельче, выборку увеличивают, а не считают точнее.
Разбор на нашем прогоне: 90 ответов
В августе 2026 мы прогоняли банк из 30 вопросов по интернет-магазину техники для дома через ChatGPT, Perplexity и DeepSeek. Получилось 90 ответов — это весь знаменатель.
Магазин не был назван ни в одном ответе. Доля упоминаний — 0 из 90, то есть 0%. Доля голоса тоже 0%, и она здесь именно считается: другие бренды в ответах были, знаменатель не пуст.
А доля рекомендаций по этому прогону не рассчитывается: ответов с упоминанием магазина нет, и делить на них нечего. В отчёте стоит пометка, а не ноль.
Ссылку на страницу магазина Perplexity дал один раз, не рекомендуя сам магазин. Доля ответов со ссылкой — 1 из 90, 1,1%. Классический случай, когда цитирование есть, а упоминания нет.
Вместо магазина ассистенты называли федеральные сети и маркетплейсы. Вывод по этой нише: соперник здесь не соседний магазин, а сети, которые собирали каталог и упоминания годами.
Что портит замер и как это заметить
Семь ошибок, после которых цифра перестаёт что-либо значить. Пять — про дисциплину прогона, две — про выводы.
- Банк вопросов меняется между замерами. Добавили три вопроса — сравнивать можно только по старым. Видно по журналу: номера вопросов не совпадают с прошлым месяцем.
- Один прогон вместо повторов. Доля меняется от запуска к запуску. Поймаете сразу: два повтора одного вопроса дадут разные наборы компаний.
- Вопросы с названием бренда в общей выборке. Доля упоминаний завышается: вы спросили про себя, ассистент про вас и ответил. Видно по тексту вопросов в журнале.
- Память и история чата включены. Ассистент повторяет то, что вы ему рассказали раньше. Признак — детали о компании, которых нет в открытых источниках.
- Регионы и языки смешаны. Половина прогона из Москвы, половина с VPN. Видно по колонке с условиями: если её не ведут, ошибку не поймать вообще.
- Вывод по одному месяцу. Первый замер — только точка отсчёта. По нашему ориентиру о динамике говорят с третьего замера, когда видно направление, а не разброс.
- Состав выборки изменился, а доли сравнили. Одна модель отказала на все вопросы — совокупная цифра несопоставима. Сравнивайте разрезы, которые есть в оба месяца: те же модели, те же номера вопросов.
Проверить себя проще всего одним вопросом: смог бы другой человек повторить ваш замер по записям и получить сопоставимую цифру? Если нет — в журнале не хватает колонок с условиями.
Что покажут бесплатные панели и когда нужен трекер
Часть замера отдают сами поисковики, бесплатно и без прогонов. Это не замена ручному замеру: панели видят только свои ИИ-ответы и ничего не знают про ChatGPT и Perplexity.
В Яндекс Вебмастере есть отчёт «Видимость сайта в Алисе AI». Его метрика — share of voice: доля ответов Алисы AI, в которых сайт попал в источники. Рядом — примеры запросов и сайты той же тематики.
Абсолютных показов и кликов там нет, и это сделано осознанно: по справке инструмент оценивает представленность сайта в ответах, а не количественные характеристики. Данные за три месяца, обновление раз в неделю.
Выборка у отчёта узкая: берутся только запросы, по которым сайт уже достаточно высоко в поисковой выдаче. По темам, где вы не ранжируетесь, он промолчит или напишет «пока недостаточно данных».
В Google Search Console с 31 августа 2026 года доступен отчёт по генеративному ИИ, и метрика там другая — показы ссылок на сайт в Обзорах от ИИ и Режиме ИИ. Отчёт есть не у всех: нужен объём показов.
Поэтому две панели не складываются в одну цифру: у Яндекса это относительная доля на своей выборке, у Google — счётчик показов. И ни та, ни другая не считают долю упоминаний бренда по вашему банку вопросов.
Общее у них одно: оба отчёта построены на ссылках на сайт. Если компанию назвали текстом и ссылку не поставили, ни один из них этого не увидит — именно для этого и нужен ручной прогон.
Платный трекер решает одну задачу: убирает ручную работу, когда ответов становится сотни. Выбирают его по четырём вопросам, а не по красоте дашборда.
- Какие модели и какие регионы он опрашивает — и есть ли среди них российские.
- Можно ли загрузить свой банк вопросов, а не пользоваться сгенерированным.
- Отдаёт ли сырые тексты ответов и список источников на выгрузку.
- Как часто обновляет данные и видно ли по ним историю, а не только последний съём.
Названий и цен мы здесь не приводим осознанно: ни один из трекеров мы не сверяли с ручным прогоном по одной методике, а без такой сверки сравнивать их цифры между собой некорректно.
Что делать с результатом: три гипотезы
Журнал не ставит диагноз, а сужает круг. Из него выходит одна из трёх гипотез, и у каждой свои первые проверки. Замер полезен ровно настолько, насколько он меняет план работ.
| Что в журнале | Гипотеза | Что проверить первым |
|---|---|---|
| Ни упоминаний, ни ссылок | Моделям не из чего вас назвать | Индексацию и доступность сайта, режим прогона и сам банк вопросов — и только потом источники |
| Ссылки есть, упоминаний нет | Материалы читают, а компанию не рекомендуют | Есть ли на сайте факты для сравнения: цены, условия, география, отзывы |
| Упоминания есть, но с ошибками | Модель опирается на устаревшие данные | Где эти данные опубликованы, и исправить первоисточник: сайт, карточки, каталоги |
Первую гипотезу до выводов проходят по шагам. Иначе «нас нигде нет» окажется дефектом замера, а не положением дел.
- Сайт доступен и в индексе. Google оговаривает: страница попадает в его ИИ-ответы только если проиндексирована и может показываться со сниппетом, а индексация и показ не гарантированы.
- Показ в ИИ-функциях не запрещён. Проверьте, не закрыт ли сайт от генеративных функций Google: справка Search Console называет такой запрет отдельной причиной, почему отчёта нет.
- Режим прогона тот самый. Без включённого поиска по интернету ассистент отвечает по памяти модели, и свежих компаний в ответе может не оказаться вообще.
- Банк вопросов релевантен. Если формулировки шире вашей ниши, в ответ придут федеральные игроки, и вас там быть не должно.
Если четыре пункта пройдены, ноль остаётся наблюдением по выбранным ответам. Дальше проверяют гипотезу о нехватке или слабости источников о компании — сам по себе ноль в журнале её не подтверждает.
Google прямо оговаривает: выполнение его требований не гарантирует ни обхода, ни индексации, ни показа. Значит, ноль возможен и тогда, когда источники о компании есть.
Гипотезу проверяют отдельно — смотрят, что и где написано о компании. Колонка «источники» в журнале показывает только то, что модель выбрала в этих ответах, а не весь набор сведений о вас.
В нашем прогоне по магазину техники ассистенты отвечали каталогами, картами и обзорами: на статьи пришлось 28 источников из 418. Это вывод по рознице, а не по всем нишам.
А по B2B-сервисам у нас вышла другая раскладка: сравнения на vc.ru и Хабре, страницы самих сервисов, подборки «лучшие инструменты для…». Свою раскладку смотрят по колонке «источники» в журнале.
Во втором случае работают страницы, которые похожи на источник: с характеристиками, условиями и прямыми ответами на вопросы покупателя. Что именно проверить на сайте — в нашем плане подготовки к AI-поиску на 30 дней.
Третий случай решается прямее остальных: ассистент берёт факты из открытых данных. Правят первоисточник — сайт, карточку в справочнике, профиль — а результат проверяют следующим замером, не раньше.
FAQ: замер видимости в нейросетях
Что такое видимость бренда в нейросетях?
Доля ответов ассистента, в которых названа ваша компания, по заранее зафиксированному списку вопросов покупателя.
Это статистика по ответам, а не позиция: снимок поисковой выдачи при фиксированных условиях воспроизводится, а текст ответа нейросети — нет.
Сколько вопросов нужно для замера?
Базовый вариант — 10 вопросов на две модели с двумя повторами, это 40 ответов. Расширенный — 30 вопросов, три модели, три повтора.
Чем меньше ответов, тем грубее шкала: при 40 зачтённых ответах её шаг — 2,5 процентных пункта, и одно новое упоминание ещё не динамика.
Можно ли измерить видимость одним вопросом в ChatGPT?
Нет. Ответ генерируется заново при каждом обращении, поэтому одна попытка показывает случай, а не долю.
Как быстрая проверка «знает ли меня ассистент вообще» один вопрос годится, как замер — нет.
Чем упоминание бренда отличается от цитирования сайта?
Упоминание — название компании в тексте ответа. Цитирование — ссылка на ваши страницы в источниках. Они встречаются и по отдельности.
В нашем прогоне на 90 ответах магазин не был назван ни разу, а ссылку на его страницу ассистент дал один раз.
Как часто повторять замер?
Раз в месяц, в один и тот же день, тем же банком вопросов и в тех же условиях.
По нашему ориентиру о динамике имеет смысл говорить с третьего замера: на двух точках не отличить направление от разброса.
Где посмотреть видимость в нейросетях бесплатно?
По Алисе — отчёт «Видимость сайта в Алисе AI» в Яндекс Вебмастере, по Google — отчёт по генеративному ИИ в Search Console.
Метрики у них разные: Яндекс даёт долю ответов с сайтом в источниках, Google — показы ссылок. Упоминание бренда без ссылки не видит ни один.
Что сделать на этой неделе
- Выпишите 10 вопросов из последних разговоров с клиентами — так, как их задал бы человек ассистенту, без названия вашей компании.
- Зафиксируйте условия одной строкой: какие две модели, сколько повторов, какой регион, поиск по интернету включён или нет.
- Заведите журнал на девять колонок из раздела про шаг 3 и прогоните банк целиком — по нашему ориентиру это один вечер.
- Посчитайте две доли — упоминаний и ответов со ссылкой — и поставьте в календарь повтор на тот же день следующего месяца.
- Если в журнале ноль и ноль, сначала пройдите четыре проверки из раздела про гипотезы. Как мы делаем прогон — на странице GEO-продвижения в нейросетях.


